学习路径生成器
🎯 你想学什么? 输入你的学习目标,AI 会从 100+ 思维模型中为你规划个性化学习路径 生成学习路径 生成中... 💡 试试这些目标: 提升决策能力 学会系统思考 提高沟通影响力 对抗认知偏差 建立个人知识体系 重新生成 分享路径 重试
🎯 你想学什么? 输入你的学习目标,AI 会从 100+ 思维模型中为你规划个性化学习路径 生成学习路径 生成中... 💡 试试这些目标: 提升决策能力 学会系统思考 提高沟通影响力 对抗认知偏差 建立个人知识体系 重新生成 分享路径 重试
上一篇说了怎么把 100 个模型连成网。这篇说说这些知识怎么来的,以及为什么没有 AI 它们到现在还在硬盘里躺着。 5000 个文件 我试过很多笔记软件。Obsidian、Notion、SiYuan、语雀、NAS 的 note station,大概五六个。每个都用了一段时间,每个都觉得"这次应该行了"。 结果都一样:笔记越记越多,回去看的越来越少。 不是工具的问题。记下来的那个瞬间,大脑就觉得"这事处理过了",然后心安理得地忘掉。后来有一天打开 Obsidian,看着 5000 多个 md 文件,突然觉得它们对我来说已经死了。写的时候很认真,分类也清楚,但从来不翻。 第一次觉得笔记有用 转折其实很平淡。有次做某核心供应商的年度议价,我想参考半年前整理过的一段供应商比价分析。没刻意去翻,随口问了 AI。它从我知识库里把那段分析拉出来,还连带找到另一个相关的笔记——那个笔记我自己都忘了写过。 当时的感觉不是"AI 好厉害"。是"原来我记过这个东西"。 区别就在这:以前是我去找笔记,但我不找。现在笔记自己冒出来了。 RAG 技术细节不多说了。核心就一件事:把 5000 个文件切成小块,每块算一个向量存起来。问问题的时候,把问题也算成向量,找最相似的几块喂给 AI。 说白了就是给 AI 装了我的记忆。不是在互联网上搜,是在我自己的笔记里搜。 搭完之后加了个每天自动同步,这样知识库是活的,不是写完就冻住。 博客是怎么冒出来的 搭 RAG 的时候没想过写博客。博客是后来自然长出来的。 RAG 解决了"找得到",但没解决"用得上"。5000 个笔记里有很多好东西,但它们是碎片——一段分析、一个框架、几句感想。碎片能回答问题,但很难改变思维方式。 我想把碎片整理成完整的文章,有结构、有案例、有结论。整理的时候发现 AI 特别适合干这个——它能把散落在不同笔记里的相关内容找出来,帮我串到一起。 100 个思维模型就是这么来的。我有相关的笔记底稿,AI 帮我扩写、补案例、加关联。最终出来的东西,不是 AI 写的,也不是我写的,是一起整理的。 现在的状态 5000 个文件还在硬盘里,但不再吃灰了。 每天有新笔记写进去,RAG 自动同步。写博客的时候 AI 从里面找素材。读者问问题的时候 AI 从里面找答案。 回头看,这个网站——思维模型、AI 学习、决策洞察——全是这么来的。不是我先想好要做一个博客,是笔记积累到一定程度,需要一个出口。 这是第四篇。前几篇:为什么我开始写这个网站 · 网站的结构 · 100 个模型的孤岛 · 下一篇:知识不是用来收藏的
这是「本地 AI 知识库实践」系列的第五篇。前面四篇分别讲了怎么搭(v1 搭建)、怎么更聪明(v2 多跳检索)、怎么让数字可信(SPU 卡片索引)、以及 2.0 全部升级点的逻辑(2.0 全解),中间还插了一篇知识库质量审计。 这一篇是 Day 1 实录。我把知识库从「单管线 RAG」升级成了「三管线本体」,从凌晨两点半干到晚上十点,中间发现它一直在骗我。 一、凌晨两点半的怀疑 事情是这样的。凌晨两点半,我盯着屏幕,脑子里冒出一个特别不舒服的念头。 我这个天天在用的知识库,是不是在骗我。 我有个自己搭的知识库,里面是公司好几年攒下来的东西,采购记录、供应商档案、各种笔记,几万条明细,两百多家供应商。平时有什么想查的就问它一句,它检索一下给我个答案,还贴心地附上来源。 一直用得挺顺。 直到那天晚上聊事情,我心里突然咯噔了一下。它跨文件回答问题的时候,那些数字,真的是对的吗。它说「多个来源交叉验证一致」,那些来源,真的是独立的吗。 带着这个不舒服,我干了一件很 nerdy 的事。我出了一整套题去考它,43 道题,每道题我先自己去翻源文件,把标准答案和在第几行都抄下来,然后再去问它,一个字一个字地对。 结果把我看沉默了。 有一道特别典型的题,问某个采购品类四年一共花了多少钱。标准答案我去源文件里核对过,一个字一个字对的。它给我的答案,差了百分之七左右。 差得不算离谱对吧。离谱的是它的态度。它言之凿凿,说这个数字有六个独立来源交叉验证一致,可信度很高。 我顺着它给的来源一个个去翻。所谓六个独立来源,其实是三对文件,每一对都是同一个东西改名前后的两个副本,内容一字不差。它拿六份复印件互相印证,告诉我这是独立信源。 你敢信??? 这还不是最吓人的。更吓人的是我继续往下测,发现它有另外一批问题,干脆不回答。不是拒绝,是返回一片空白。我以为是随机故障,反复重试,同样的题,三次,全空。而正确答案明明就躺在它检索到的资料里。 还有一种更隐蔽的。有的问题,它会说「资料中查不到」。我一开始觉得这是诚实,挺好的。后来我翻文件发现,答案就在那里,它检索到了那个文件,只是没检索到带着答案的那一段,于是它基于残缺的上下文,斩钉截铁地告诉我这个东西不存在。 你看,这三种错误,一种编造,一种沉默,一种否认存在。最可怕的是第三种,因为它看起来最像诚实。 二、机制病 那天晚上我想明白了一件事。我的知识库得的是一种机制病,不是 bug。 它的工作方式是,把几万个文档切成碎片,按相似度捞出一把,然后让一个大模型把这些碎片拼成一个答案。这个机制天生擅长聊天,天生不擅长算术。你问它隔壁老王姓什么,它可能给你编一个。你让它把三百行数据加起来,它可能给你加错。这不是它笨,是它的构造里本来就没有「精确」这两个字。 所以修 bug 是没用的。机制病,要换机制。 顺带说个扎心的。我这个库上个月的「质量评分」是 9.6 分,看着挺美。这次实测之后我给它重新打了分,9.4。分数降了,但这次是卸了妆的 9.4——把「检索会稳定输出作废数字」「八分之一的题直接空答」这些病全部显性化之后的分数。带病的 9.6 和卸妆的 9.4,我选后者。 三、三管线 我花了一整天,把知识库改成了三个各司其职的部分。 第一种问题,多少钱、占多少比例、哪年涨没涨。这类有唯一正确答案的,不让大模型碰。全部交给一个老会计,一个确定性引擎,数据从冻结的权威源一次性灌进去,带指纹校验,查询全程没有生成模型的参与。你问账上的事,他翻账本,一分钱不会错,账上没有的,他会说这条查不到。 第二种问题,这家供应商还供着哪些品类、这个物料断供了有没有替代、交易链条里有没有绕圈的关联。这类要顺着关系一层层往下爬,老会计的账本翻不动。我给它画了一张地图,把几万条采购明细变成一张图,供应商、物料、品类、年份全是节点,采购行为全是边。查询就是在地图上走路,走一步是一步,走到没有路,就承认没有路。 第三种问题,才是真正需要大模型的。某个东西为什么重要,某篇文章讲了什么道理。这类没有唯一答案,让大模型发挥。但我也给它上了规矩,旁边配了个门卫,检索到的资料里如果混着过期的、被作废的来源,门卫直接把问题拦下来,把权威文件的路径列出来让我自己去查。 我给这套东西立了一条规矩,叫宁拒不错。答不了就拒答,拒绝不算失败,编造才算。这条规矩立完之后我发现,系统回答我的方式都变了。以前它是个什么都敢说的百科全书,现在它更像那个靠谱的老会计。 说真的,这句话值钱。 四、把几万条明细画成一张图 图本体是这天的重头戏。采购明细83,715 行,每一行变成一条带属性的边,供应商、物料、品类、年份变成节点,再加供应商映射、品类归并、关联方关系,六类实体一张图,60 多 MB 的 SQLite 单文件,零新服务,指纹不符直接拒答。 老规矩,建完先建锚点再考它。采购总额、分年金额、供应商数量、品类数量,全部对上才算建成功。然后再注入一个故意改错的总额,看它认不认。它拒绝了。很好,坏锚点混不进去。 然后是十道多跳压测题。每道题都要跨五个以上的资料来源,在关系链上爬好几层,全是旧系统必挂的题型。 五、十道题,零编造 压测结果,十道题里零编造。 我印象最深的是一道跨了好几层的题。我问它,那几个供应大头,除了自己的主业,还偷偷往哪些品类渗透。它挨个在图上爬完,回来告诉我,一家只干主业,一家在九个品类里各有零星几千块的边角料,头部仍然只有主业。还有一家,直接查无此人。 查无此人这四个字,后来我发现也是准的。因为那家的叫法和图库里的登记名,真的对不上。它没有硬凑一个名字相似的家伙来交差。 还有一道跨域题,问销售线和采购风险有没有重叠。它在采购半段直接给了个硬结论,某关联方 entity 就挂在该品类供应商头部,和另一道题测出的「该关联方在某品类占九成」互相咬合。而销售域那半段,它老实承认图里没有这个概念,拒答。 ...
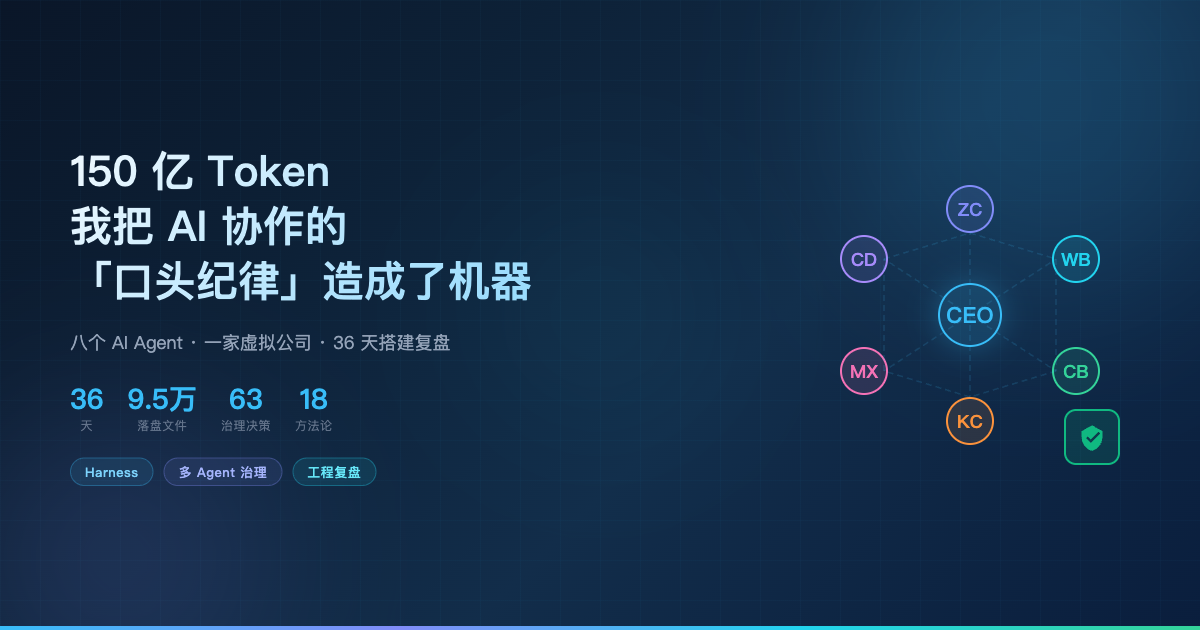
一个多智能体 Harness 系统的完整搭建复盘 36 天 · 9.5 万份落盘文件 · 63 份治理决策 · 约 150 亿 Token 先给一组实测数字,这篇文章的每一节都会回到它们: 维度 数字 口径 Token 消耗 约 150 亿 运营者估算口径¹,跨全部 Agent 会话累计,含大量重放与测试;系统自身无法精确计量 治理时间窗 36 天(2026-08-11 → 09-15) 决策记录首末日期实测 工作区落盘文件 95,686 个 交付当日 find 实测 Harness 机制文档 716 个 00_HARNESS/ 目录实测,其中带日期戳的 229 份集中在 5 天内产出 治理决策 20 份公司决策 + 42 份董事长指令 07_决策记录/ 与 01_董事长指令/ 实测 常驻钩子 6 个,2,169 行代码 ~/.zcode/hooks/ 实测,全部带运行留痕 ¹ 「150 亿」是运营者跨全部 Agent 会话的累计估算,含大量重放、回归测试与行为基线消耗。系统至今无法跨供应商精确归集 Token——这本身就是本文第十章指出的体系盲区之一。实际生产性消耗约为总量的三到四成。 ...
我给自己那个本地知识库打了两年多的分。 9 月 10 日晚上,它拿到 9.3 / 10。理由很充分:23 条死链、10 篇笔记缺 frontmatter、5 个收件箱积压、一个战略主题零覆盖。 三个小时后,同一套方法、同一套权重、同一批命令,再算一遍:9.7 / 10。 这三个小时里,我没有往库里加一行新知识。只是把已经烂掉的地方挖出来扔了。 但真正的故事不在 9.3 到 9.7。真正的故事是——第一份写着"9.7"的报告里,有一处举证是不实的,而且是复核的时候才发现的。 这是"本地 AI 知识库实践"系列的第五篇。前面四篇讲的是怎么搭(从零搭建本地 AI 知识库)、怎么更聪明、怎么让数字可信(卡片索引层)、2.0 时代改了哪些东西(知识库 2.0 升级全解)。这一篇讲的是怎么证明它真的好——以及为什么"它说自己好"这句话本身不可信。 本文全部数字来自 2026-09-10 的现场实测命令,可复现。你的库不必有相同的数字,方法相同即可。 一、三个小时:完整时间线 整件事从当天晚上 22:47 开始,到 23:58 结束。 时间 动作 结果 22:47 第一次审计(六维评分模型) 9.3 / 10,三项 P1/P2 弱点 23:00–23:18 弱点清零执行 死链 23→0、缺 frontmatter 10→0、收件箱积压 5→0 23:18–23:30 复审(同方法、同权重) 9.7 / 10,九项门槛全过 23:31–23:45 独立复核(另一个 Agent 重跑全部指标) 采信 9.7,但发现 1 项举证不实 + 2 项需修正 + 4 项缺口 23:40–23:58 缺口全量执行 7 项动作落地,向量块 121,951 → 122,120 收尾 稳态复核 死链 0 / frontmatter 0 / 漂移 0 / 积压 0 / 回归 21/21 注意中间那一行——复审和独立复核是两个不同的动作,由两个不同的角色做。 ...
一、下午三点,老板丢过来一张截图 截图上是一个手打的表格:五家供应商的名字、每家供什么货,旁边一行手写的折扣——94 折、93 折、87 折。配一句话:「这几家,去年 9 月到今年 8 月,一共采购了多少?」 看起来是个再简单不过的问题。 如果你手上有系统,标准动作是这样的:找导出文件、按供应商筛选、求和、检查一下财年有没有对上、再算一遍打折前的金额。顺利的话一小时,不顺利的话,一下午就没了。 而我花了 90 秒。 不是因为我手快,也不是因为我记得住这些数字。是因为这个问题里所有会卡住你的地方,我的知识库早就知道了。 二、这个"简单问题"里藏着五道关 我把它拆开,你就明白"导个表就行"是个错觉。 第一关:哪个文件才是权威源? 采购数据在我手上至少有两个来源:业务系统的导出,和财务部发的正式入库明细。更要命的是,从今年 1 月起财务口径替换了旧口径——旧的那套已经作废,但文件还好好地躺在硬盘上。选错文件,数字全错,而且错得特别像对的。 第二关:财年不等于自然年。 老板说的"去年 9 月到今年 8 月",是 2025-09-01 到 2026-08-31。但你的系统默认按自然年汇总,所以导出来的第一版一定是错的,而且往往要等你对完总数才发现。 第三关:一个窗口,两套数据源,不能重复算。 旧系统的数据到 2026 年 6 月截止,财务新数据从 2026 年 1 月开始。中间有大半年是重叠的。直接拼起来会重复计算,只用旧的又会少掉两个月。 第四关:老板给的名字,不一定是系统里的名字。 这次最典型的是压缩机——我按老板说的那个品牌名去筛供应商,结果是零。系统是零。后来才发现,它是品牌,不是供应商:量分散在四个不同的代理商名下,只能靠物料名称里的品牌词把它捞出来。如果当时就停在"查无此家",这个数就永久漏掉了。 第五关:要的是打折前还是打折后?含税还是不含税? 老板问"采购了多少",通常指实付。但一谈到返点(Rebate),双方真正博弈的是打折前的盘子——87 折的价目表里到底留了多少空间,才是谈判的战场。这两个数差了将近一成,答错一个,报价当场就漏了底。 五道关,每一道都不难。但每一道都要你自己"想起来",而想起来这件事,在下午三点被人追问的时候,是最不可靠的。 所以"导个表就行"的真相是:你根本不是在跟一个求和操作搏斗,你是在跟五个从来没人记录过的判断搏斗。每做一个判断都要停下来想、去翻记录、去问人,或者赌一把。更要命的是这些判断之间没有提示,错了也不会报错——只有最后总数对不上的时候,你才知道前面某一关塌了。 这就是为什么这件事"顺利一小时,不顺利一下午"。差别不在你的 Excel 熟不熟,在你有没有把这五个判断提前固化下来。 三、有知识库的人,这五道关变成了一句话 我实际做的事只有一句:「调这五家供应商 FY26 的采购数据」。 后面发生的一切,全靠知识库里早就写好的东西: 关卡 靠什么自动解决 存在哪 用哪个文件 数据目录的 README 写明正式口径、作废文件及作废原因 数据源目录 财年怎么算 项目策略文件写死"FY = 9 月到次年 8 月" 根目录策略文档 中间重叠期 口径切换点 + 覆盖范围 + 已知缺陷,全部标注 数据说明文件 名字对不上 品牌、代理商、供应商的对照关系 索引与实体表 含税/不含税 金额口径、明细条数、重复行留档状态 每条数据说明 所以 AI 做的事不是"猜",是照着已经固化好的口径去取数。这是本质区别——前者是概率,后者是流程。 ...
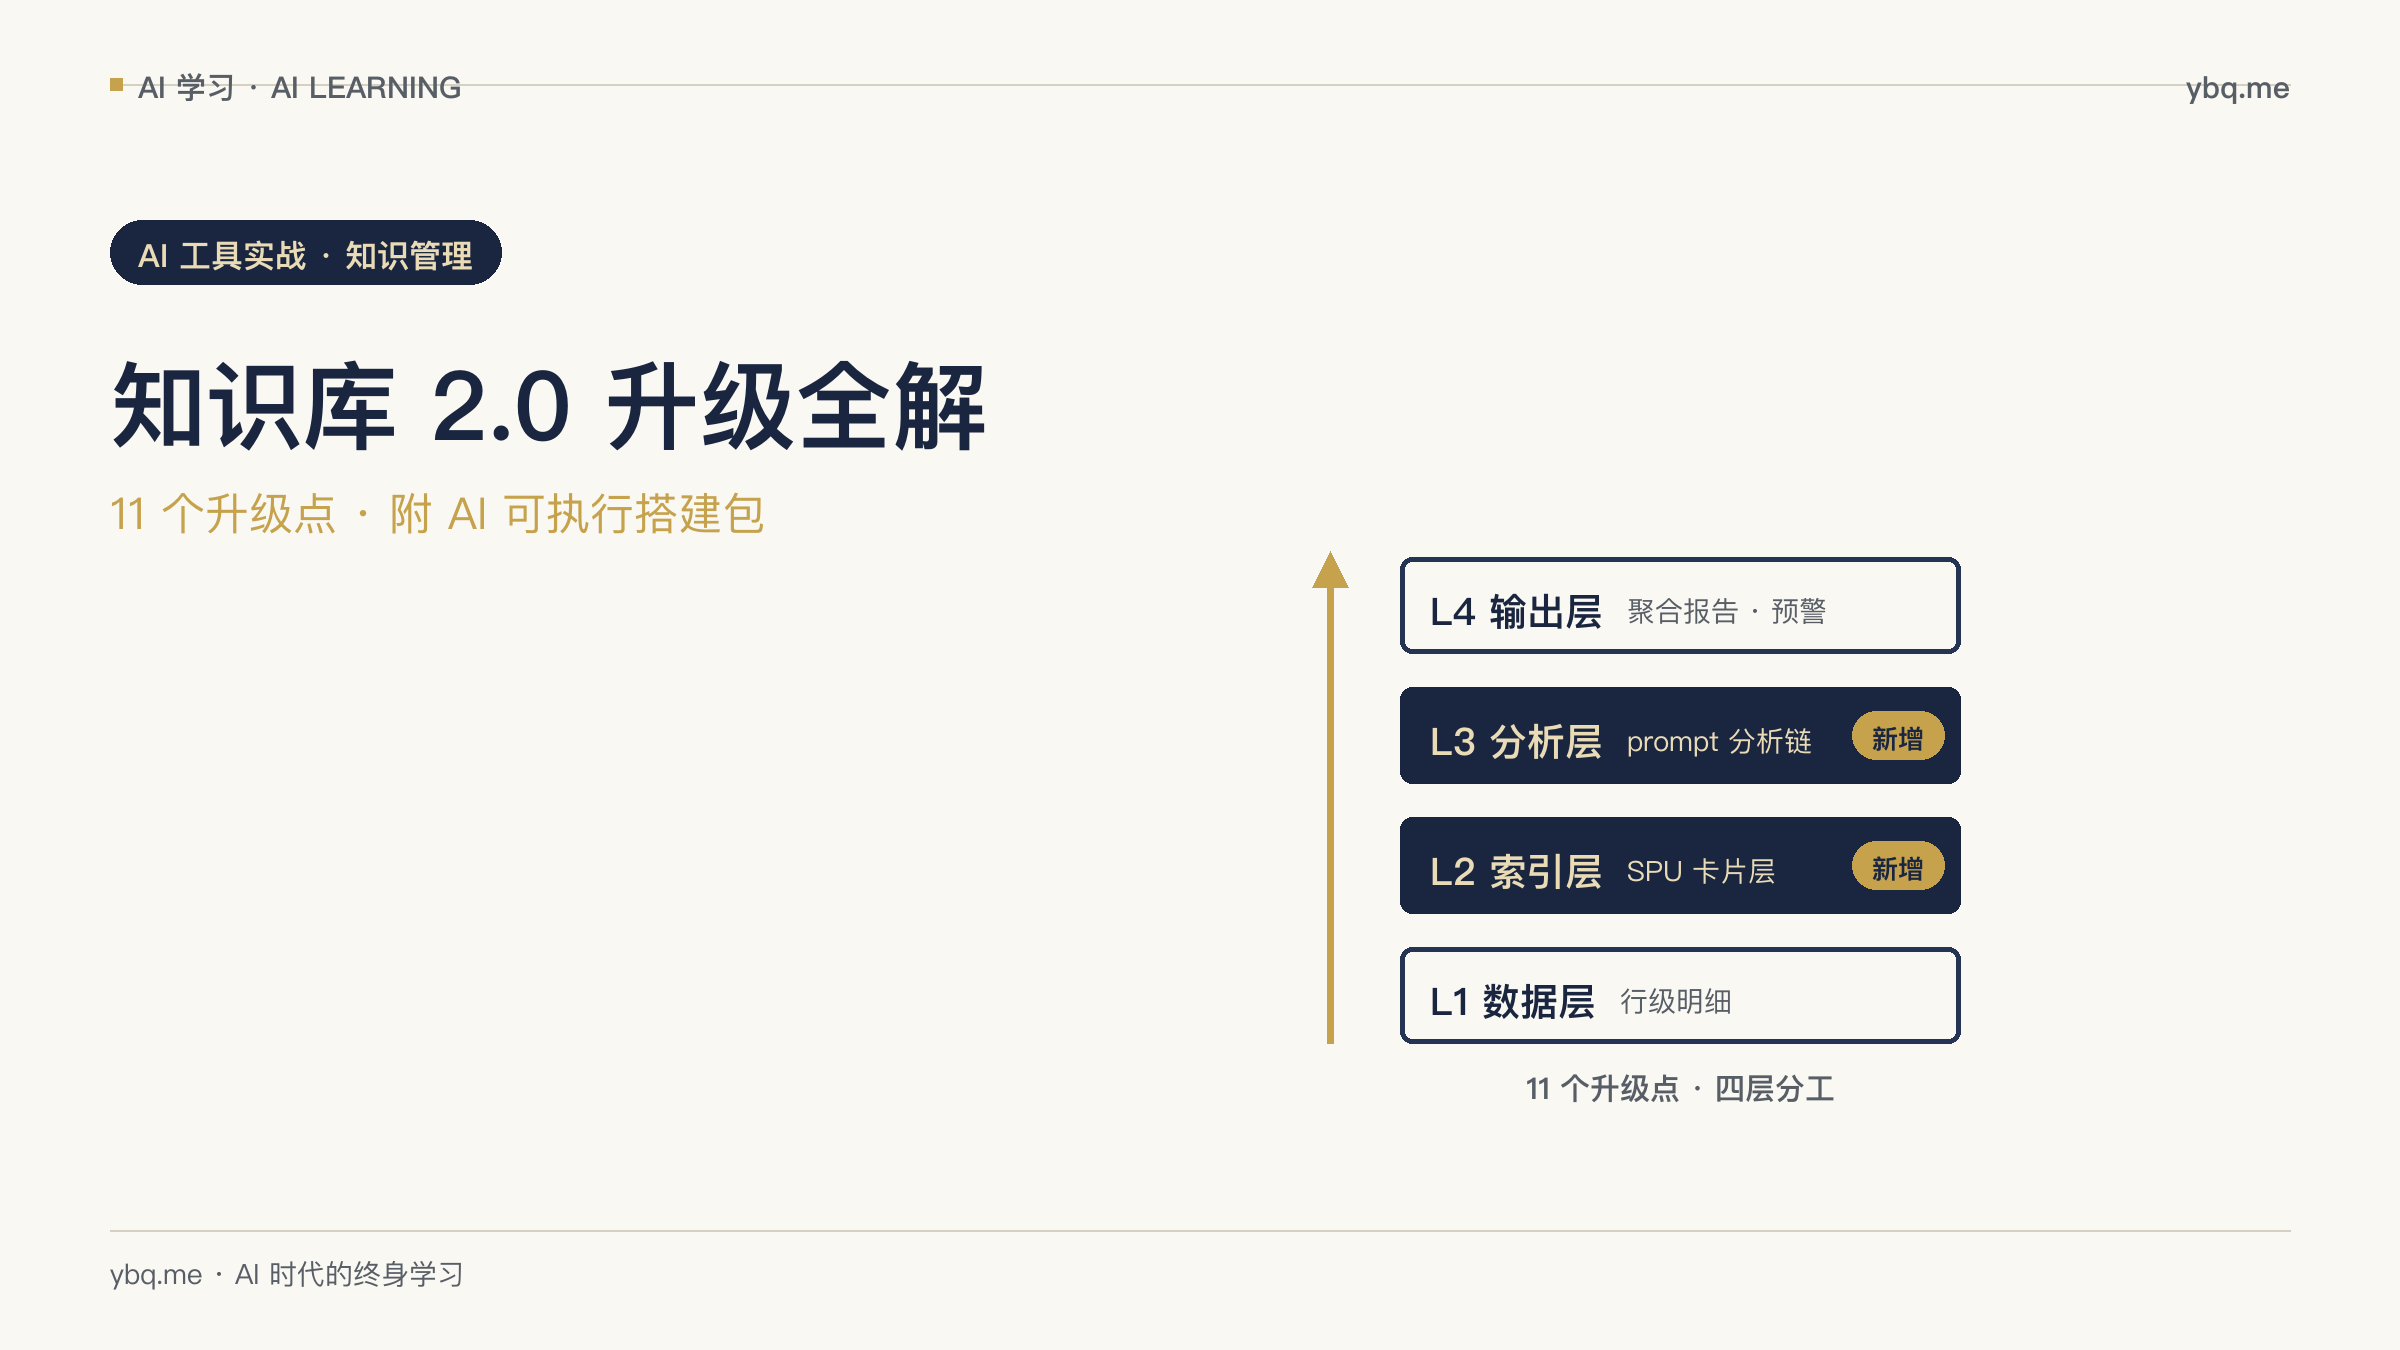
这是"本地 AI 知识库实践"系列的第四篇。前面三篇分别讲了:怎么搭(v1 搭建)、怎么更聪明(v2 多跳检索 + 看板)、怎么让数字可信(知识库 2.0 卡片索引)。 这篇把 2.0 时代的全部升级点一次性讲透:每个点改了什么、为什么改、逻辑是什么、好处是什么——不是"我做了这些",而是"我为什么这么做"。 文末附一段可以直接复制给任何 AI 助手的搭建包:5 个可运行脚本 + 验收清单,AI 照着就能在一个全新目录里复刻整套架构。 本文数字均来自 2026-08-31 实测(记分卡 + 自动化清单交叉核验),非估算。你的数字不必相同,架构相同即可。 一、SPU 卡片索引层:知识库 2.0 的核心 改了什么:给每个物料编码(SPU)生成一张预聚合的标准答案卡(约 2KB JSON),把 AI 从"在 78,647 行长表里挑数"变成"读 1 张卡"。生产环境 23,743 张卡。 为什么改:RAG 的天花板是——能找文件、算不准数字。长表塞进上下文,模型挑数就像在电话簿里核对账单,看错行的概率永远不为零,而且错得理直气壮。我实测问过"铜管是不是涨价了",RAG 捞回几段话,一对原始数据,数字全错。 逻辑:四层分工,每层只干自己擅长的事: 1 2 3 4 5 6 7 8 9 ┌─────────────────────────────────────┐ │ L4 输出层 聚合报告(TOP10/预警/对标) │ ├─────────────────────────────────────┤ │ L3 分析层 粗筛→族归组→下钻(prompt链) │ ├─────────────────────────────────────┤ │ L2 索引层 SPU 卡片 × 23,743 │ ├─────────────────────────────────────┤ │ L1 数据层 行级明细 78,647 行(黄金源) │ └─────────────────────────────────────┘ 好处:铜管核查从 30-60 分钟人工透视压缩到 6 秒;上下文从全表 10.3MB 降到 59KB(-99.4%);每个数字带"数据行号"指针可一键回溯;结构性事实(5 个铜管编码全是同一家供应商)粗筛一眼可见——这是议价谈判里最值钱的信息,传统透视几乎发现不了。 ...
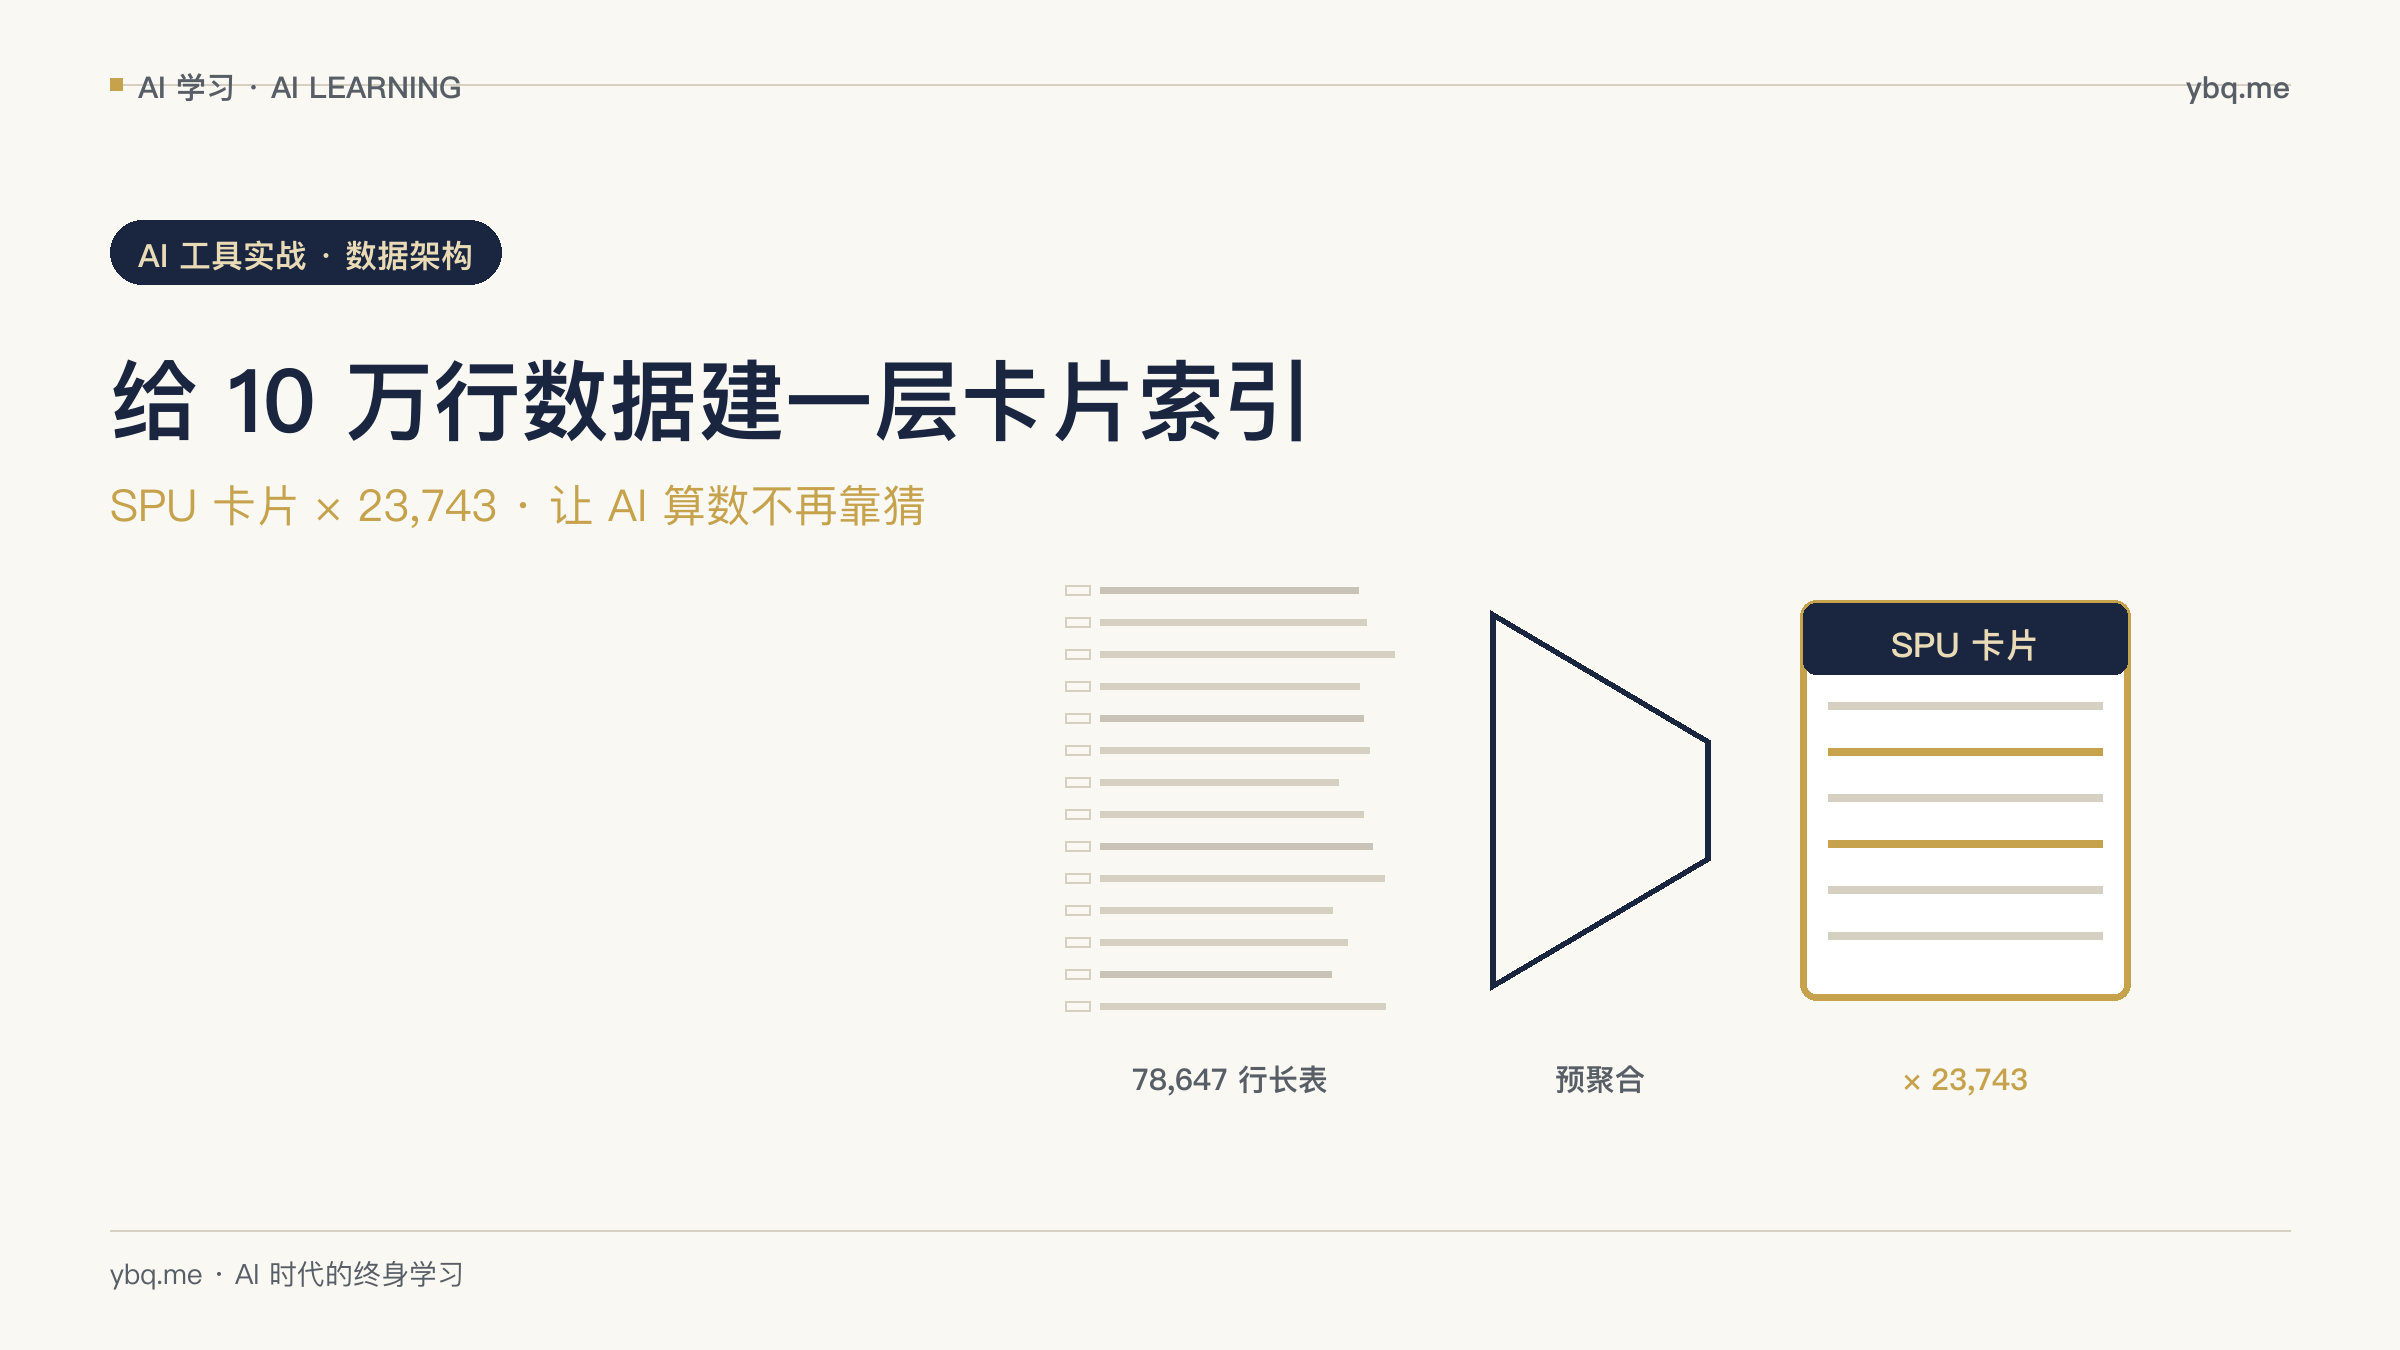
我有一个已经跑了一年多的本地知识库:PARA 结构、单索引 RAG + 卡片索引层、每日增量同步、21 题召回回归。检索能力经过验证——问"青春期孩子怎么沟通"它能从 300 问 Q&A 里精准捞出答案。 但上个月我问它一个问题,它露馅了。 我问:“铜管是不是涨价了?涨了多少?” RAG 给我捞回来几段文字,每段都说得像模像样。但我一对原始数据——数字对不上。模型从 78,647 行的采购长表里"挑"数字,挑错了行、错了口径,还挑得理直气壮。 这就是 RAG 的天花板:它能找到"哪份文件讲了什么",但它算不准"数字到底是多少"。 长表格塞进上下文窗口,模型挑数就像让人在电话簿里核对账单——看错行的概率永远不为零。 这篇文章记录我怎么解决这个问题:给知识库加一层「SPU 卡片索引」,让 AI 从"在长表里挑数"变成"读一张预聚合的小卡片"。文末有完整的搭建方法和踩坑清单。 一、核心思路:三层分工 升级后的知识库分三层,每层只干自己擅长的事: 1 2 3 4 5 6 7 8 9 ┌─────────────────────────────────────┐ │ L4 输出层 聚合报告(TOP10/预警/对标) │ ├─────────────────────────────────────┤ │ L3 分析层 粗筛→族归组→下钻(prompt链) │ ← 新增 ├─────────────────────────────────────┤ │ L2 索引层 SPU 卡片 × 23,743 │ ← 新增 ├─────────────────────────────────────┤ │ L1 数据层 行级明细 78,647 行 │ ← 已有(Cost-DNA) └─────────────────────────────────────┘ RAG 层(原有):负责"哪份文件讲了什么"——模糊知识、背景、方法论 卡片层(新增):负责"数字到底是多少"——每个 SPU 一张预聚合的标准答案 LLM 层:只负责"这意味着什么"——解读、判断、建议 关键设计:卡片是 JSON 格式,刻意不进 RAG 索引。RAG 擅长语义匹配,不擅长精确算数——让它俩各守边界,互不污染。 ...
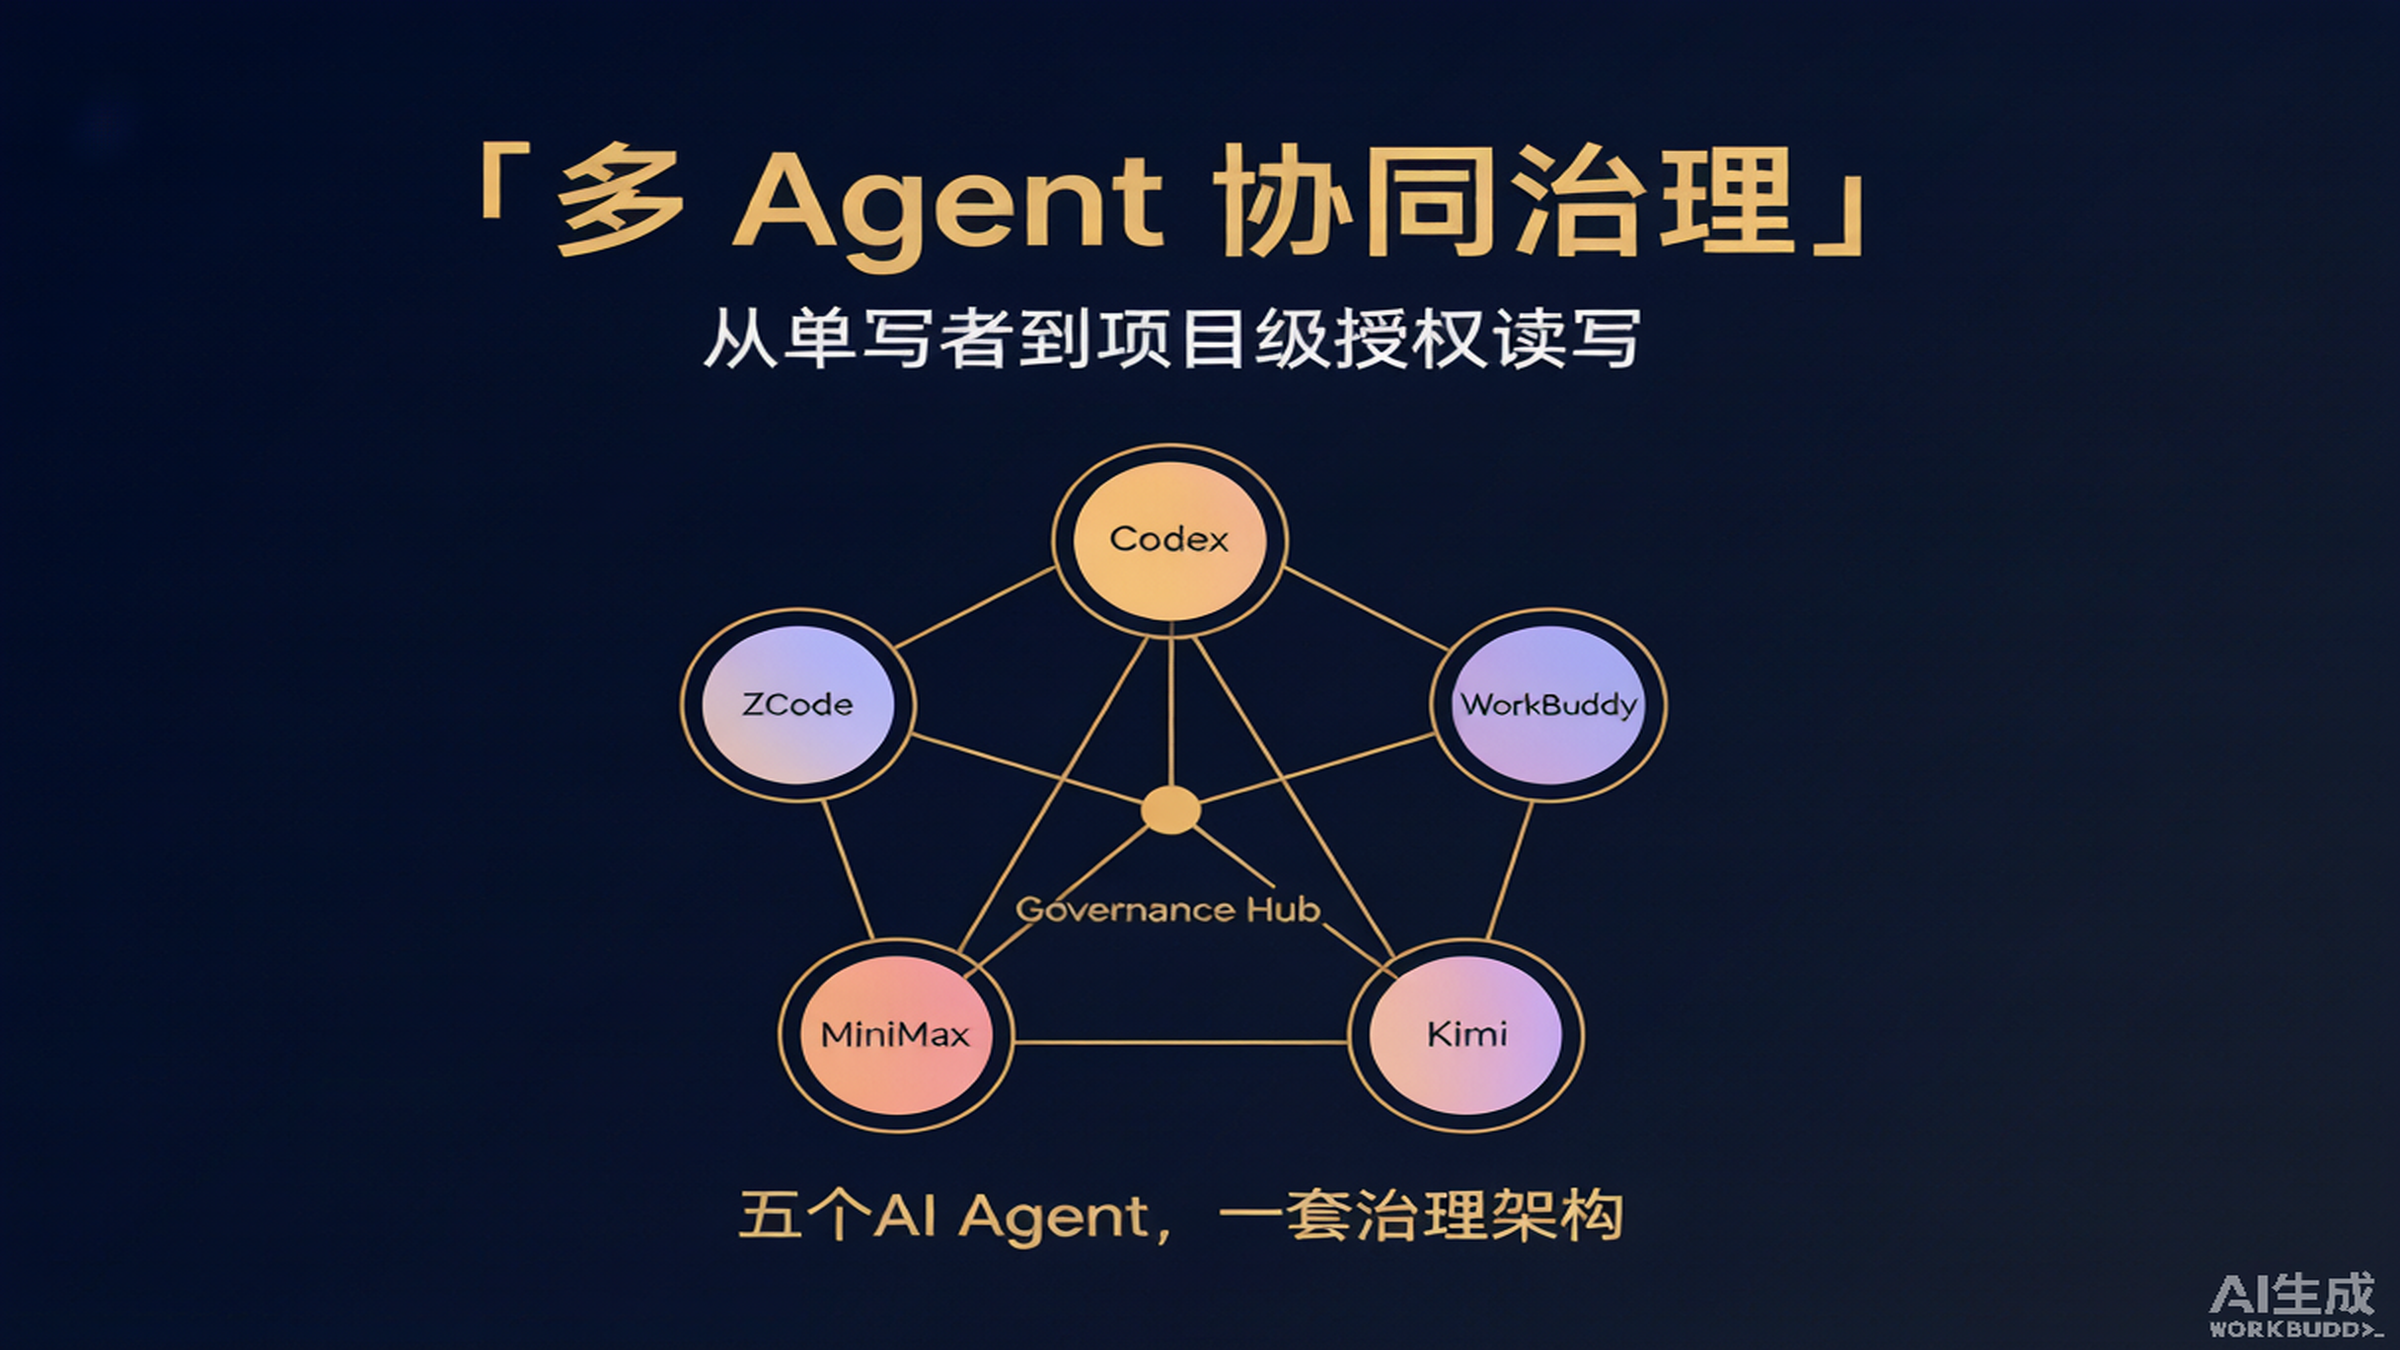
版本说明(2026-08-31):本文描述的"双索引 RAG"是 2026-07 的架构快照。2026-08 起知识库已简化为单索引 + SPU 卡片索引层——表格聚合的职责由「防爆块规则 + 排除清单」和「SPU 卡片层」承接(详见《从零搭建本地 AI 知识库》)。治理原则、权限矩阵与交接闭环不受影响,仍然完全有效。 你有没有遇到过这种场景:你让 AI 帮你改一个文件,改完发现另一个 AI 也在改同一个文件,两边改的内容互相覆盖,最后谁的都没保留? 这不是技术 bug,是治理缺失。 我有一个 5000+ 文件的知识库,用双索引 RAG(A 索引含表格聚合 / B 索引零表格,numpy 向量 + reranker)做检索。当我开始引入多个 AI Agent(Codex、WorkBuddy、ZCode、Kimi Work、MiniMax Code)协同工作时,新问题出现了:谁来写?谁来审?怎么协调?RAG 什么时候更新? 我要说一个大多数人不同意的观点:AI Agent 的能力不是瓶颈,治理才是。 大多数人以为"Agent 不够聪明"是问题——错了。真正的问题是"Agent 太自由了"——它们能写任何文件、改任何配置、跑任何命令,但没有人告诉它们"什么不该做"。这就像给 5 个实习生每人一把公司钥匙,但没有门禁系统——迟早出事。 本文拆解我从踩坑到成熟的三轮迭代:从"一个 Agent 垄断所有写入"到"项目级授权读写",最终找到一套稳定的多 Agent 治理架构。 一、问题:建完 RAG 之后的新困境 上篇写完时,我的知识库已经跑起来了:5000+ 文件、双索引 RAG(A 索引含表格聚合 / B 索引零表格)、每日增量同步、领域 wiki。技术层没问题。 但当我开始引入多个 AI Agent 协同工作时,新问题出现了: 谁来写? 如果 5 个 Agent 都能改同一个文件,冲突只是时间问题。 谁来审? Agent 写的东西不一定对,需要有人把关。 怎么协调? A Agent 改了配置,B Agent 不知道,继续按旧配置执行。 RAG 什么时候更新? 文件改了但索引没更新,检索结果就是旧的。 这不是技术问题,是治理问题。技术问题有标准答案,治理问题没有——它需要你根据实际情况不断迭代。 ...
你有没有这种经历:明明记得看过一篇文章,但搜遍了所有笔记都找不到? 或者:你有一个业务问题想问 AI,但 AI 给的答案和你的实际情况完全不搭——因为它根本不知道你的业务数据长什么样。 这不是 AI 的问题,是你没有给它一个能读懂的知识库。 市面上 60 多款知识库工具我都看过。Obsidian、Notion、SiYuan 这些笔记工具,上手快但检索只能关键词,AI 集成深度不够。Dify、RAGFlow、AnythingLLM 这些 AI 知识库工具,5 分钟能搭一个客服库,但数据格式私有、SaaS 不敢放业务数据、索引策略动不了。 我要说一个大多数人不同意的观点:知识库不是"存资料的仓库",而是"能帮你做判断的伙伴"。 如果你的知识库不能回答你自己的业务问题,它只是另一个收藏夹。真正的知识库应该能回答"某物料 A 与 B 供应商 2026 采购价格对比"这种具体问题——答案来自你自己的数据,不是 LLM 编造的。 本文拆解如何从零搭建一套数千文件、双索引 RAG、每日自动增量同步的本地 AI 知识库——一个业务管理者的"第二大脑"实战。文末附录包含一段可直接复制给任何 AI 助手的搭建指令和完整代码,让 AI 照着就能搭。 一、为什么不是 Obsidian / Notion / Dify? 市面上 60 多款工具我都看过。它们分为两类: 范式 代表 优点 致命缺陷(对我) 笔记工具 Obsidian、Notion、SiYuan 上手快、移动端好 检索只能关键词,AI 集成深度不够 AI 知识库工具 Dify、RAGFlow、AnythingLLM 5 分钟搭一个客服库 数据格式私有、SaaS 不敢放业务数据、EXCLUDE/重建策略动不了 我的核心约束是: 数据主权 100% 本地:大量采购明细、供应商档案、客户报价不能进任何 SaaS。 业务深度耦合:行业计价规则、多产品线结构、供应商画像,通用工具里都没有。 AI 召回可控:哪些文件进索引、哪些排除、表格文件如何聚合,必须由我定。 所以我没有选择「现成整机」,而是选择了自建范式:纯 Markdown + 自写脚本 + 本地向量索引 + 自动化流水线。 ...