五条流水线汇入 WorkBuddy 中枢

我怎样把 WorkBuddy 用成一套常驻系统:20 个任务域背后的五条流水线

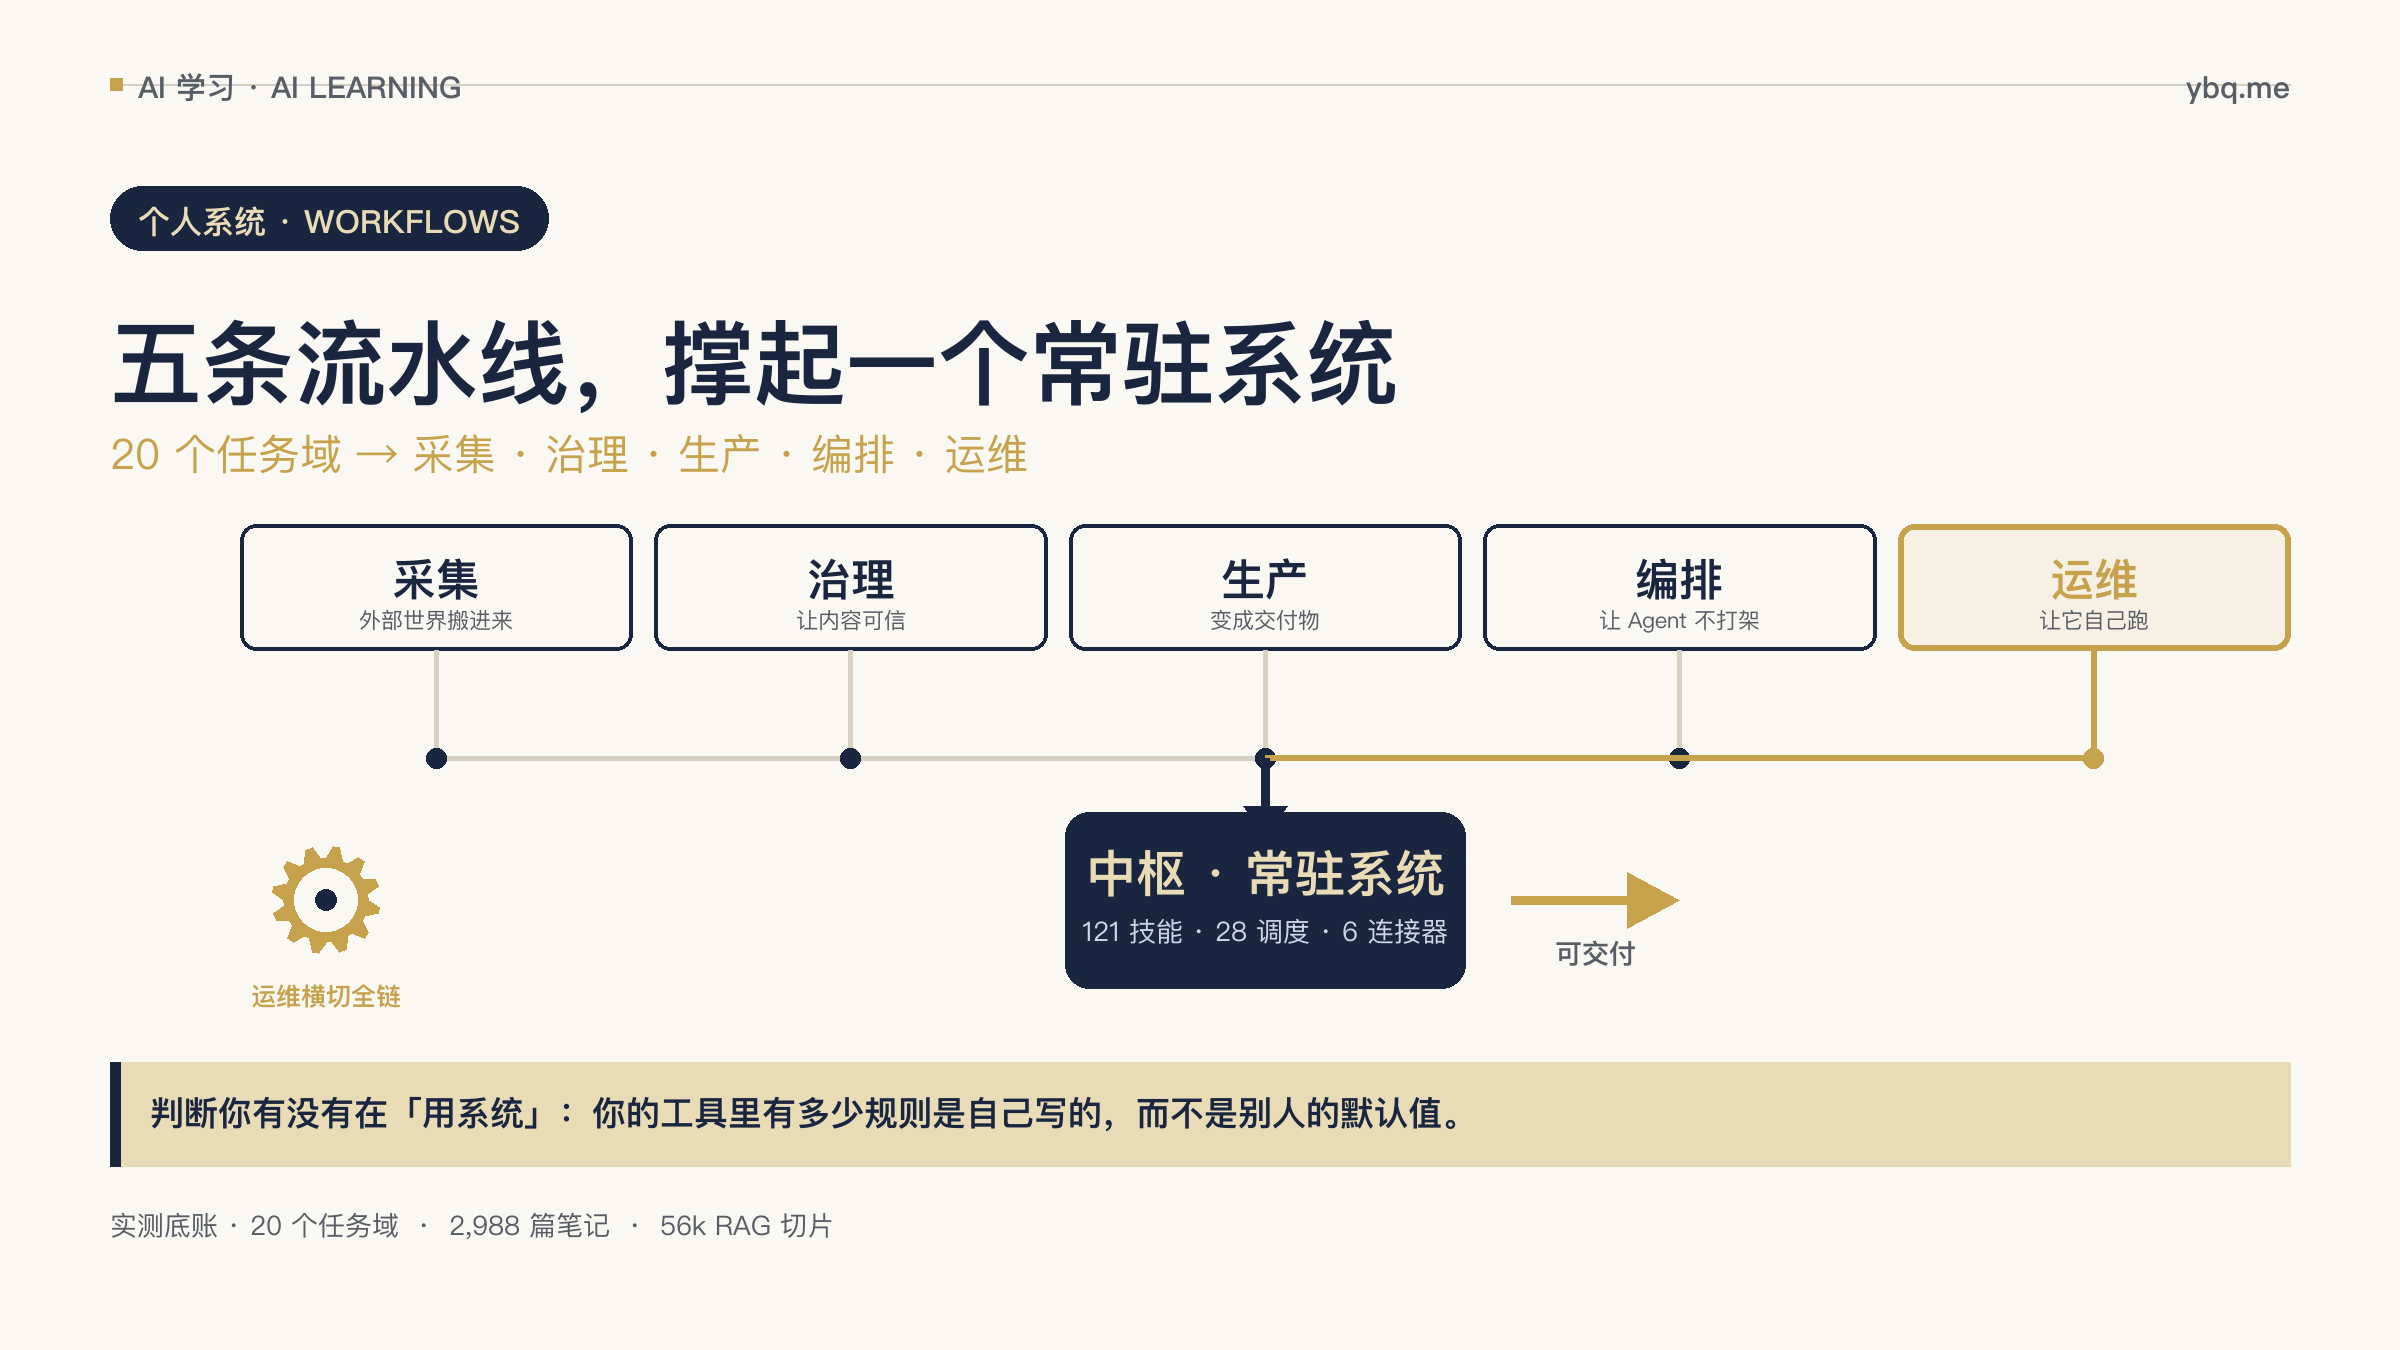
大多数人对 AI 工具的使用,停在「问答」这一层:想到什么问什么,问完就关。这个用法的问题不是效率低,而是它把 AI 降级成了一个更快的搜索引擎——你每次都在重新建立上下文,而 AI 每次都从零开始。 我用了 WorkBuddy 足够久,久到它不再是一个工具,而是我数字工作的一部分。这篇文章不复述我做了多少事,而是回答一个更有用的问题:这些事是怎么被组织起来的? 下面的底账全部来自本次实测,不是凭印象回忆: 维度 实测值 用户级技能 121 个 定时自动化 28 个(26 个在跑 / 2 个暂停) 已绑定外部连接器 6 个 知识库规模 约 2,988 个 md 文件 · 56k 个 RAG 切片 这四个数字背后,是五条常年同时运行的流水线。 一、你不是在使用工具,你是在运营一个系统 先说一个被普遍低估的事实:AI 工具的产出质量,取决于你为它设计的结构,而不是你提问的水平。 同样一个人用同一个 AI 工具,有人的用法是「一个文件夹、一堆 md、一句 prompt」;有人的用法是—— 121 个技能,每个技能是一个被验证过的流程,不是一段提示词 28 个定时任务,按黄金时段排布,凌晨干活、白天只看结果 4 层记忆:身份档案、用户偏好、项目日志、每日复盘 一套验收机制:任何「完成」声明前必须实测磁盘 这两种用法的产出差距,不是 10 倍,是两个量级。原因很简单:前者每次都在重新发明轮子,后者把轮子的制造过程本身沉淀成了资产。 我把这 121 个技能理解为流程的固化层——每一次踩坑之后问自己一句「这个坑值得写下来吗」,如果值得,它就变成一个技能,下次不用再踩。 所以判断你有没有在「用系统」,有一个简单的测试:你的 AI 工具里,有多少东西是你自己写的规则,而不是别人的默认值。 二、五条流水线:把 20 个任务域归并后的骨架 我原本列了 20 个任务域(知识库治理、邮件抽取、AIMR 治理、GPO 季度跟踪……)。但 20 个是并列关系,看不出结构。真正的结构是五条流水线——每个域都是某条流水线上的一个工位。 ...
2026-10-07 · Gary
150 亿 Token:AI 协作 Harness 搭建复盘

150 亿 Token,我把 AI 协作的「口头纪律」造成了机器

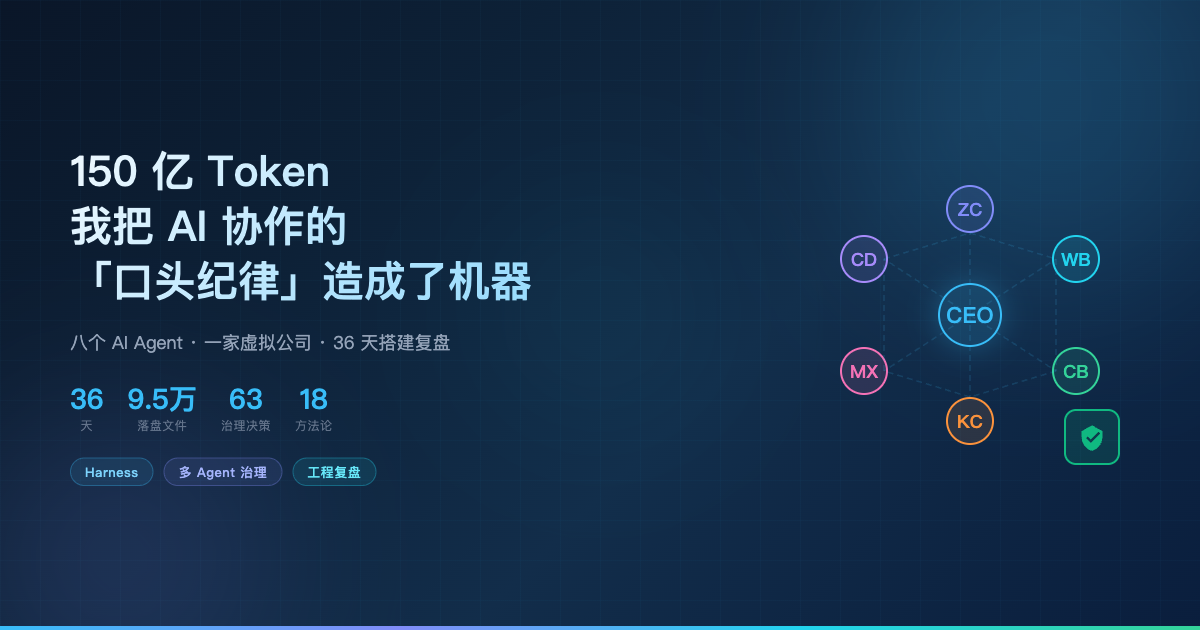
一个多智能体 Harness 系统的完整搭建复盘 36 天 · 9.5 万份落盘文件 · 63 份治理决策 · 约 150 亿 Token 先给一组实测数字,这篇文章的每一节都会回到它们: 维度 数字 口径 Token 消耗 约 150 亿 运营者估算口径¹,跨全部 Agent 会话累计,含大量重放与测试;系统自身无法精确计量 治理时间窗 36 天(2026-08-11 → 09-15) 决策记录首末日期实测 工作区落盘文件 95,686 个 交付当日 find 实测 Harness 机制文档 716 个 00_HARNESS/ 目录实测,其中带日期戳的 229 份集中在 5 天内产出 治理决策 20 份公司决策 + 42 份董事长指令 07_决策记录/ 与 01_董事长指令/ 实测 常驻钩子 6 个,2,169 行代码 ~/.zcode/hooks/ 实测,全部带运行留痕 ¹ 「150 亿」是运营者跨全部 Agent 会话的累计估算,含大量重放、回归测试与行为基线消耗。系统至今无法跨供应商精确归集 Token——这本身就是本文第十章指出的体系盲区之一。实际生产性消耗约为总量的三到四成。 ...

2026-09-16 · Gary
知识库质量跃升:从 9.3 到 9.7

知识库 3.0:从 9.3 到 9.7 —— 一次质量跃升的完整路径

我给自己那个本地知识库打了两年多的分。 9 月 10 日晚上,它拿到 9.3 / 10。理由很充分:23 条死链、10 篇笔记缺 frontmatter、5 个收件箱积压、一个战略主题零覆盖。 三个小时后,同一套方法、同一套权重、同一批命令,再算一遍:9.7 / 10。 这三个小时里,我没有往库里加一行新知识。只是把已经烂掉的地方挖出来扔了。 但真正的故事不在 9.3 到 9.7。真正的故事是——第一份写着"9.7"的报告里,有一处举证是不实的,而且是复核的时候才发现的。 这是"本地 AI 知识库实践"系列的第五篇。前面四篇讲的是怎么搭(从零搭建本地 AI 知识库)、怎么更聪明、怎么让数字可信(卡片索引层)、2.0 时代改了哪些东西(知识库 2.0 升级全解)。这一篇讲的是怎么证明它真的好——以及为什么"它说自己好"这句话本身不可信。 本文全部数字来自 2026-09-10 的现场实测命令,可复现。你的库不必有相同的数字,方法相同即可。 一、三个小时:完整时间线 整件事从当天晚上 22:47 开始,到 23:58 结束。 时间 动作 结果 22:47 第一次审计(六维评分模型) 9.3 / 10,三项 P1/P2 弱点 23:00–23:18 弱点清零执行 死链 23→0、缺 frontmatter 10→0、收件箱积压 5→0 23:18–23:30 复审(同方法、同权重) 9.7 / 10,九项门槛全过 23:31–23:45 独立复核(另一个 Agent 重跑全部指标) 采信 9.7,但发现 1 项举证不实 + 2 项需修正 + 4 项缺口 23:40–23:58 缺口全量执行 7 项动作落地,向量块 121,951 → 122,120 收尾 稳态复核 死链 0 / frontmatter 0 / 漂移 0 / 积压 0 / 回归 21/21 注意中间那一行——复审和独立复核是两个不同的动作,由两个不同的角色做。 ...

2026-09-11 · Gary
知识库 2.0 四层架构升级

知识库 2.0 升级全解:11 个升级点的逻辑与好处(附 AI 可执行搭建包)

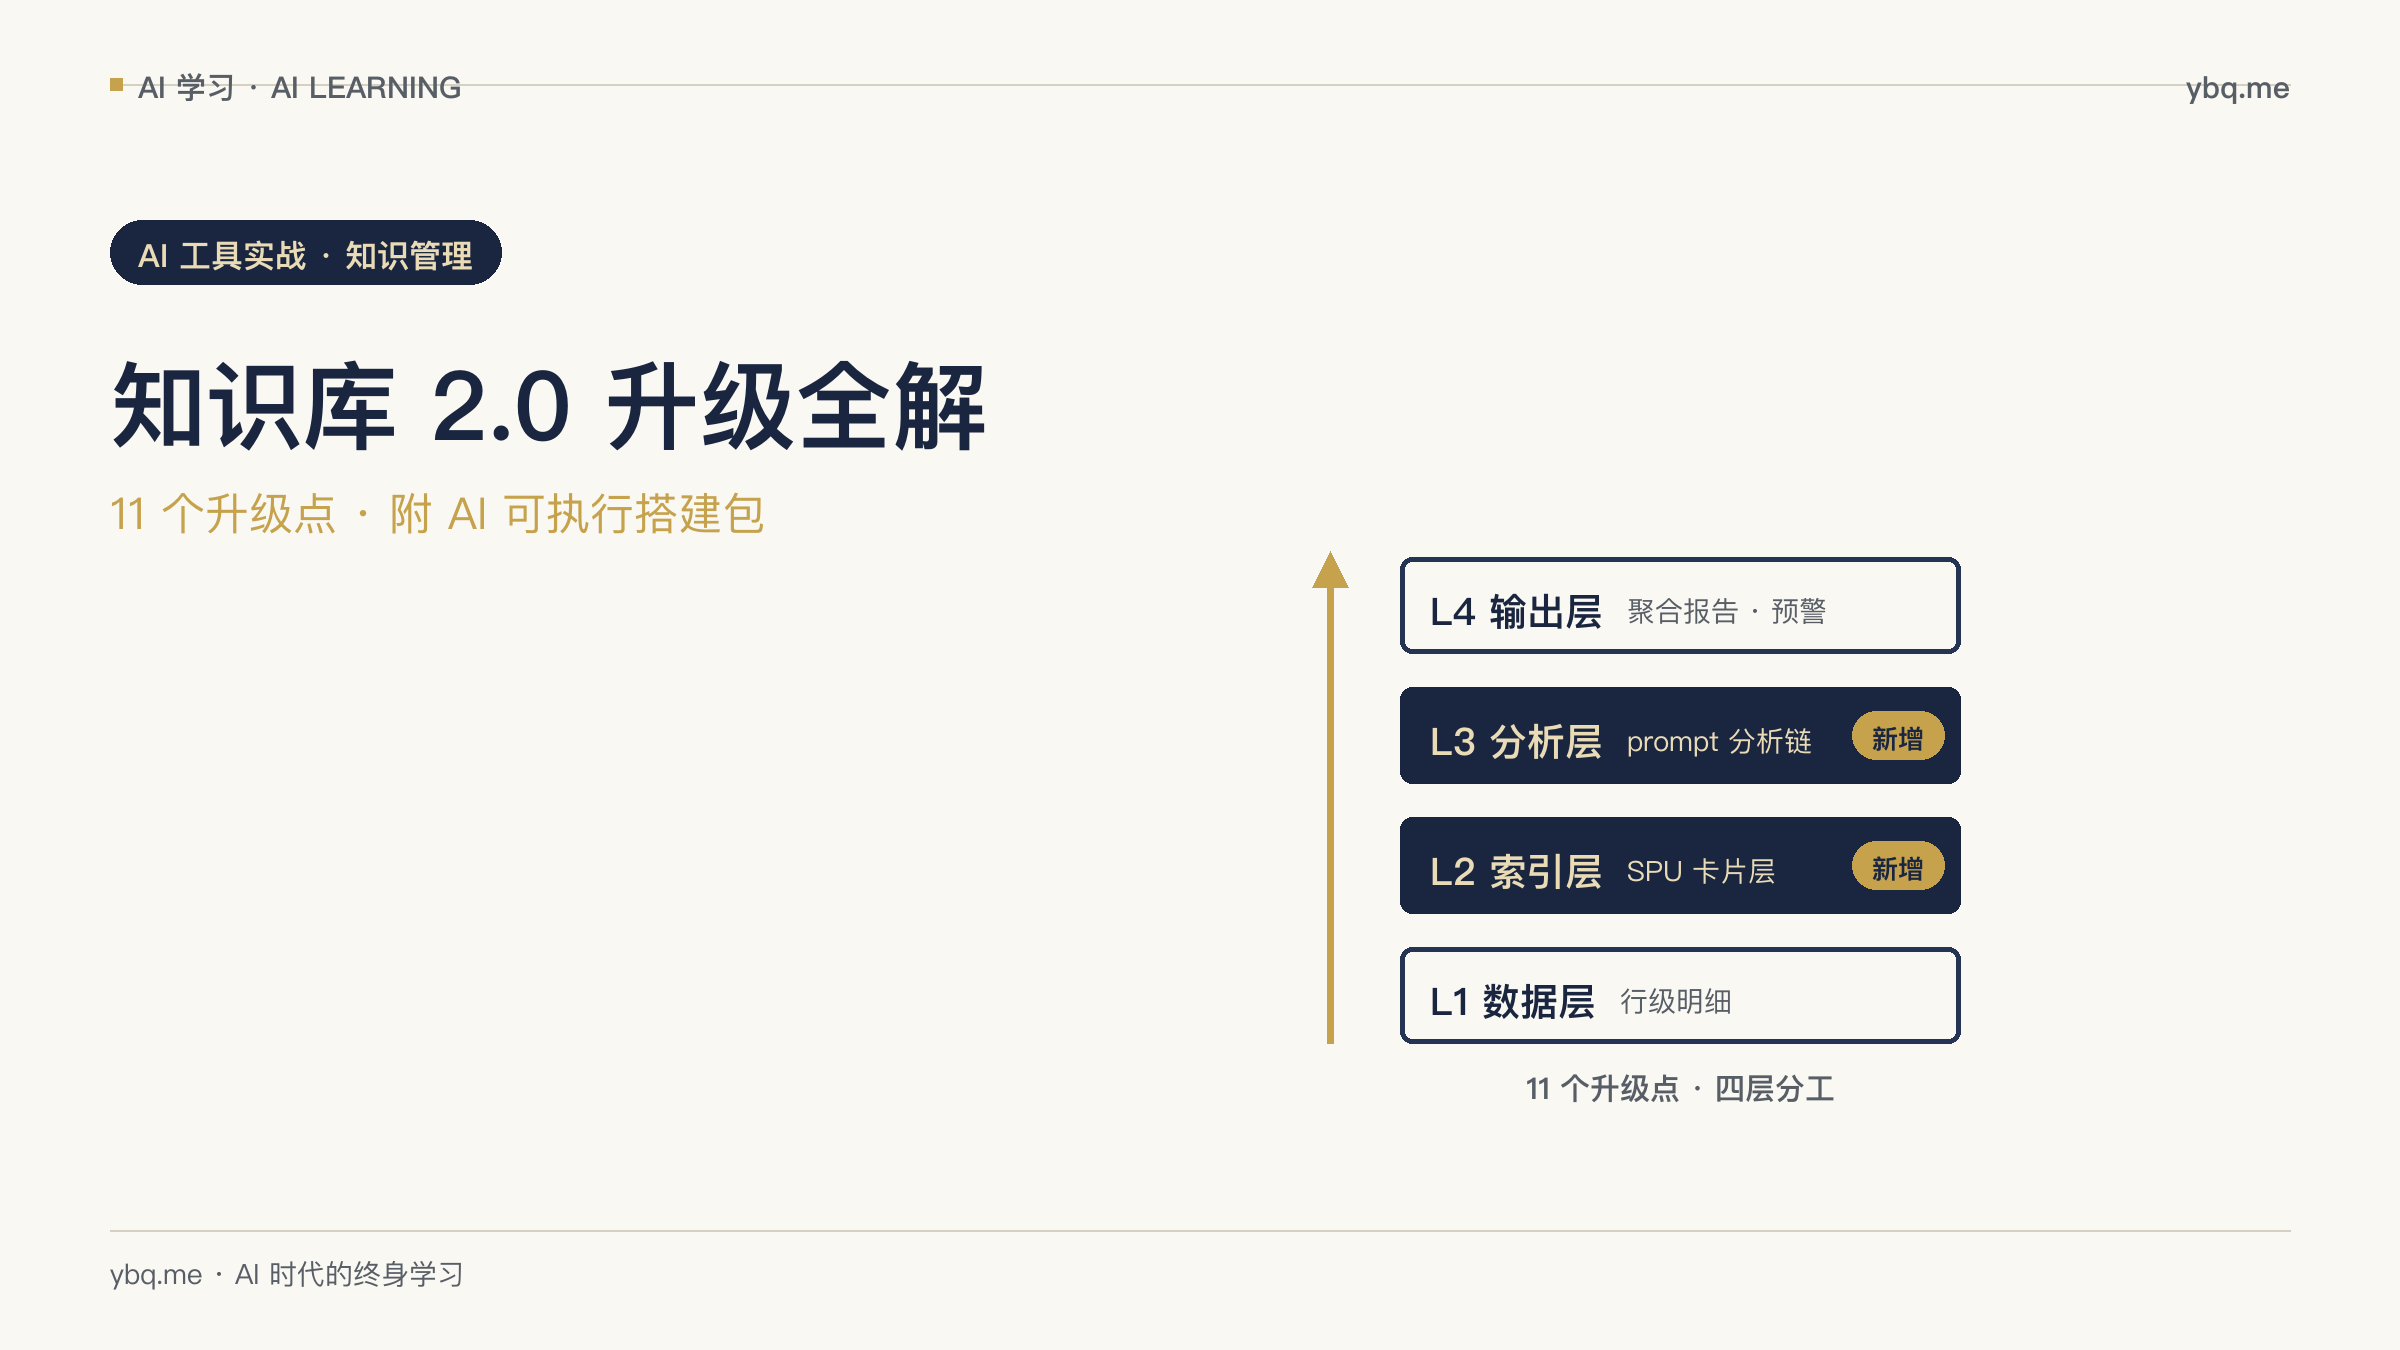
这是"本地 AI 知识库实践"系列的第四篇。前面三篇分别讲了:怎么搭(v1 搭建)、怎么更聪明(v2 多跳检索 + 看板)、怎么让数字可信(知识库 2.0 卡片索引)。 这篇把 2.0 时代的全部升级点一次性讲透:每个点改了什么、为什么改、逻辑是什么、好处是什么——不是"我做了这些",而是"我为什么这么做"。 文末附一段可以直接复制给任何 AI 助手的搭建包:5 个可运行脚本 + 验收清单,AI 照着就能在一个全新目录里复刻整套架构。 本文数字均来自 2026-08-31 实测(记分卡 + 自动化清单交叉核验),非估算。你的数字不必相同,架构相同即可。 一、SPU 卡片索引层:知识库 2.0 的核心 改了什么:给每个物料编码(SPU)生成一张预聚合的标准答案卡(约 2KB JSON),把 AI 从"在 78,647 行长表里挑数"变成"读 1 张卡"。生产环境 23,743 张卡。 为什么改:RAG 的天花板是——能找文件、算不准数字。长表塞进上下文,模型挑数就像在电话簿里核对账单,看错行的概率永远不为零,而且错得理直气壮。我实测问过"铜管是不是涨价了",RAG 捞回几段话,一对原始数据,数字全错。 逻辑:四层分工,每层只干自己擅长的事: 1 2 3 4 5 6 7 8 9 ┌─────────────────────────────────────┐ │ L4 输出层 聚合报告(TOP10/预警/对标) │ ├─────────────────────────────────────┤ │ L3 分析层 粗筛→族归组→下钻(prompt链) │ ├─────────────────────────────────────┤ │ L2 索引层 SPU 卡片 × 23,743 │ ├─────────────────────────────────────┤ │ L1 数据层 行级明细 78,647 行(黄金源) │ └─────────────────────────────────────┘ 好处:铜管核查从 30-60 分钟人工透视压缩到 6 秒;上下文从全表 10.3MB 降到 59KB(-99.4%);每个数字带"数据行号"指针可一键回溯;结构性事实(5 个铜管编码全是同一家供应商)粗筛一眼可见——这是议价谈判里最值钱的信息,传统透视几乎发现不了。 ...

2026-08-31 · Gary
SPU 卡片索引层架构

知识库 2.0:给 10 万行采购数据建一层「卡片索引」,让 AI 算数不再靠猜

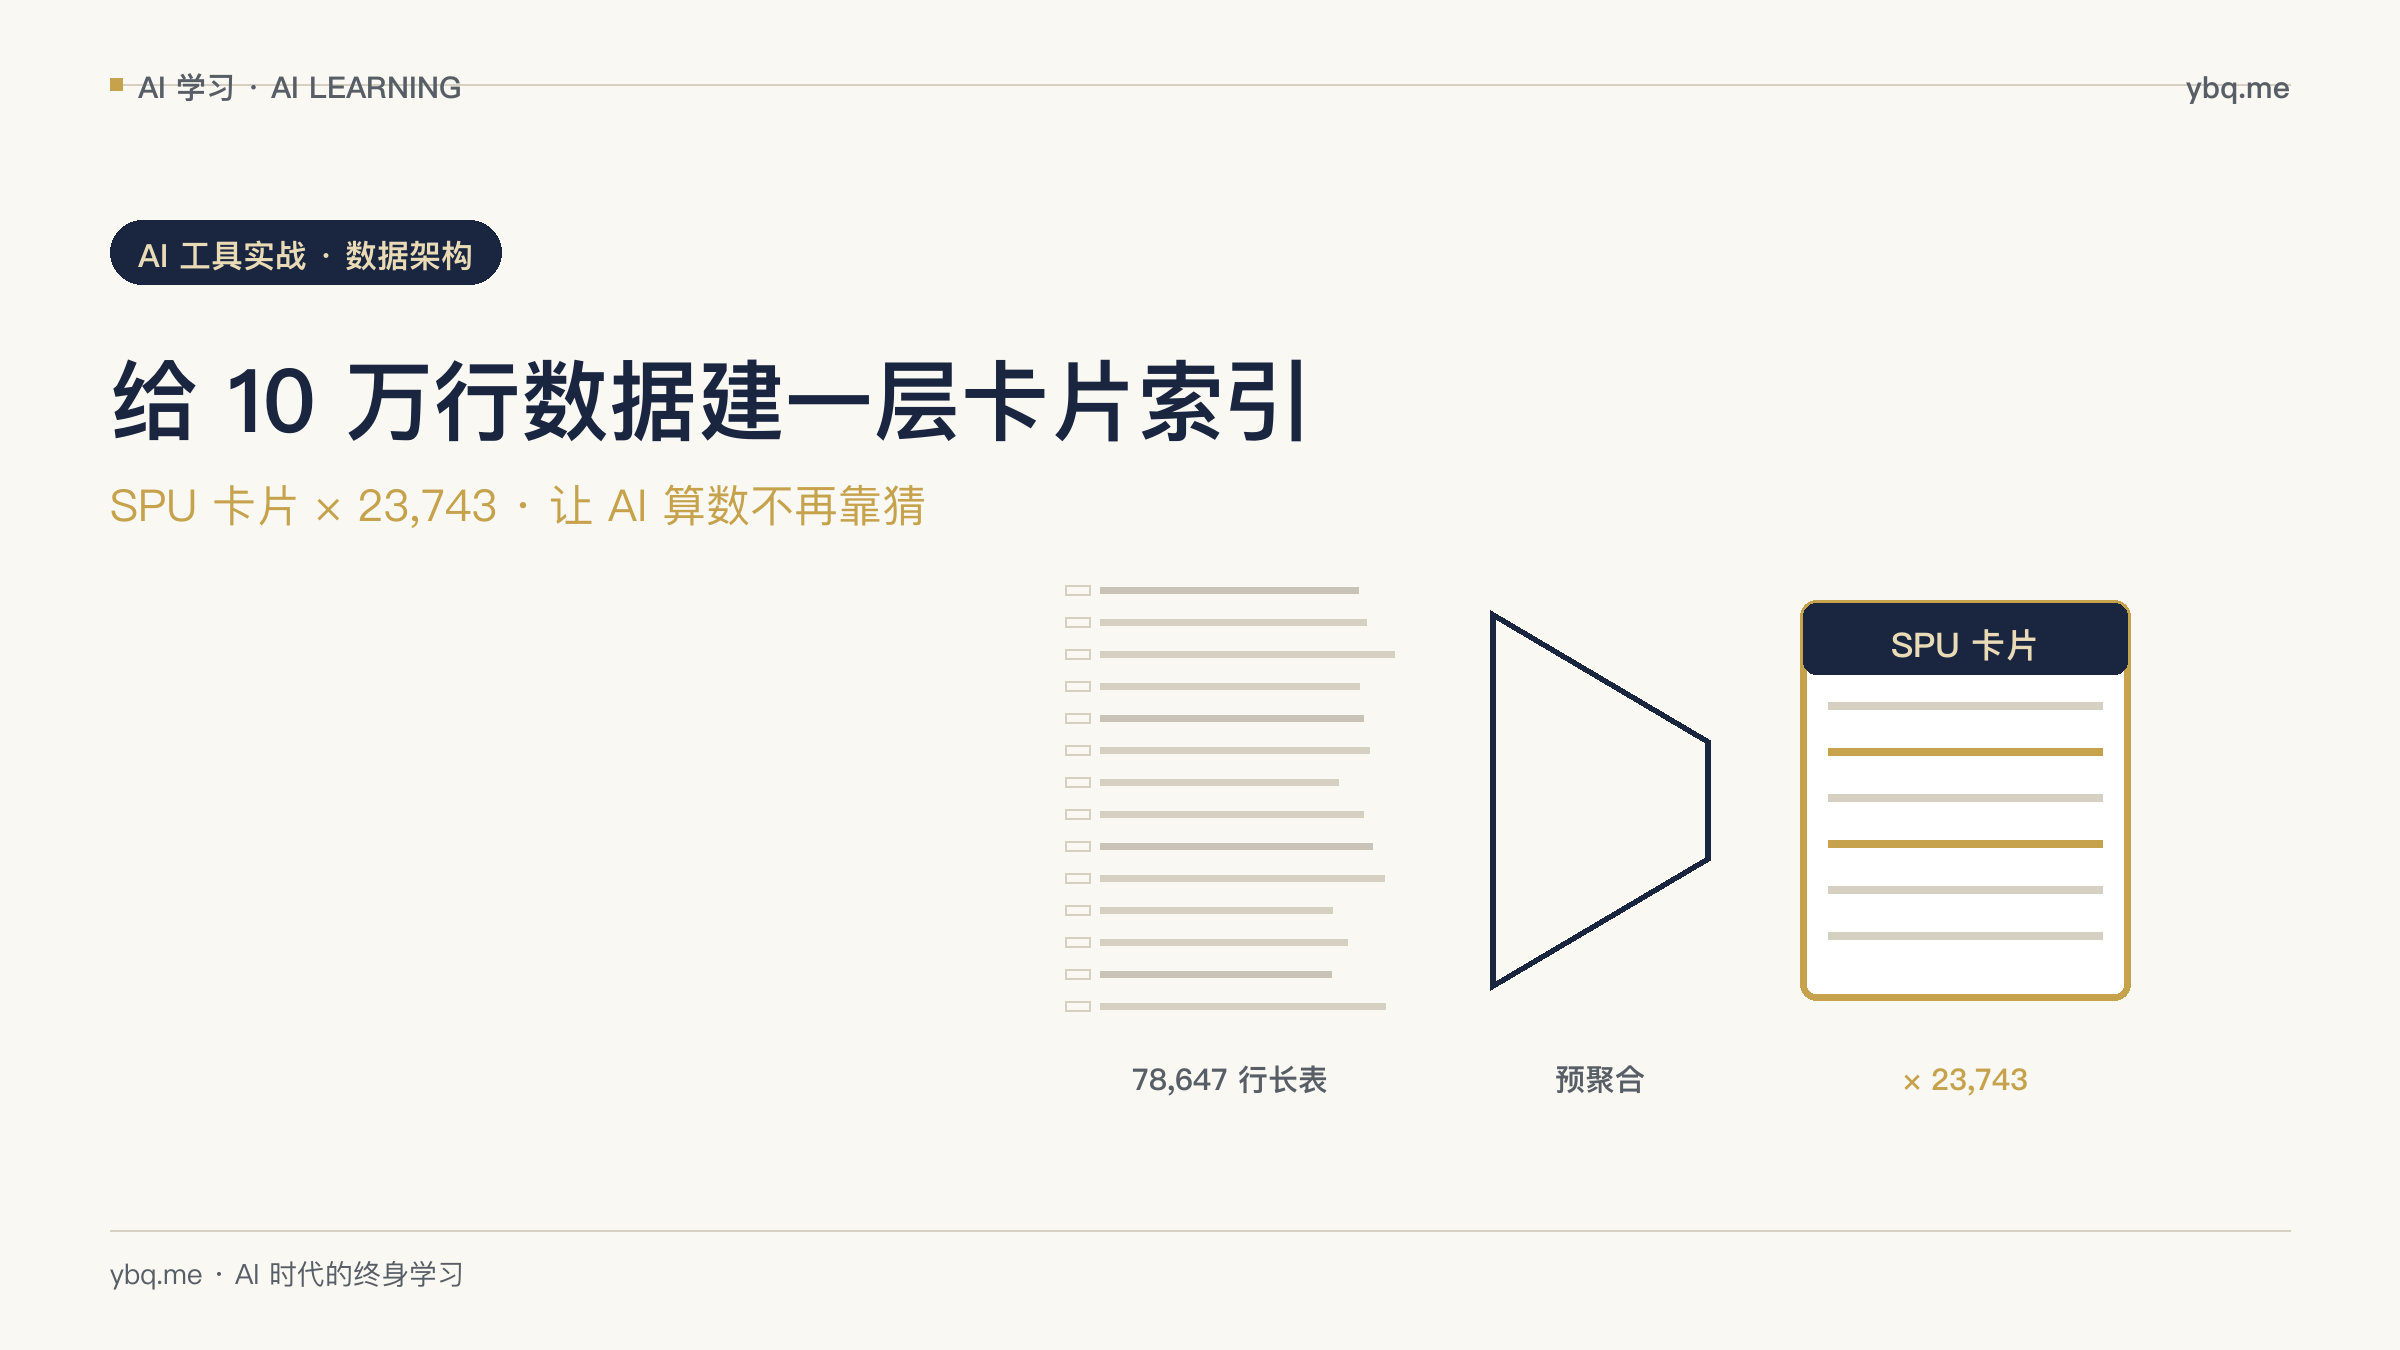
我有一个已经跑了一年多的本地知识库:PARA 结构、单索引 RAG + 卡片索引层、每日增量同步、21 题召回回归。检索能力经过验证——问"青春期孩子怎么沟通"它能从 300 问 Q&A 里精准捞出答案。 但上个月我问它一个问题,它露馅了。 我问:“铜管是不是涨价了?涨了多少?” RAG 给我捞回来几段文字,每段都说得像模像样。但我一对原始数据——数字对不上。模型从 78,647 行的采购长表里"挑"数字,挑错了行、错了口径,还挑得理直气壮。 这就是 RAG 的天花板:它能找到"哪份文件讲了什么",但它算不准"数字到底是多少"。 长表格塞进上下文窗口,模型挑数就像让人在电话簿里核对账单——看错行的概率永远不为零。 这篇文章记录我怎么解决这个问题:给知识库加一层「SPU 卡片索引」,让 AI 从"在长表里挑数"变成"读一张预聚合的小卡片"。文末有完整的搭建方法和踩坑清单。 一、核心思路:三层分工 升级后的知识库分三层,每层只干自己擅长的事: 1 2 3 4 5 6 7 8 9 ┌─────────────────────────────────────┐ │ L4 输出层 聚合报告(TOP10/预警/对标) │ ├─────────────────────────────────────┤ │ L3 分析层 粗筛→族归组→下钻(prompt链) │ ← 新增 ├─────────────────────────────────────┤ │ L2 索引层 SPU 卡片 × 23,743 │ ← 新增 ├─────────────────────────────────────┤ │ L1 数据层 行级明细 78,647 行 │ ← 已有(Cost-DNA) └─────────────────────────────────────┘ RAG 层(原有):负责"哪份文件讲了什么"——模糊知识、背景、方法论 卡片层(新增):负责"数字到底是多少"——每个 SPU 一张预聚合的标准答案 LLM 层:只负责"这意味着什么"——解读、判断、建议 关键设计:卡片是 JSON 格式,刻意不进 RAG 索引。RAG 擅长语义匹配,不擅长精确算数——让它俩各守边界,互不污染。 ...

2026-08-31 · Gary