我的知识库,学会了说「我不知道」
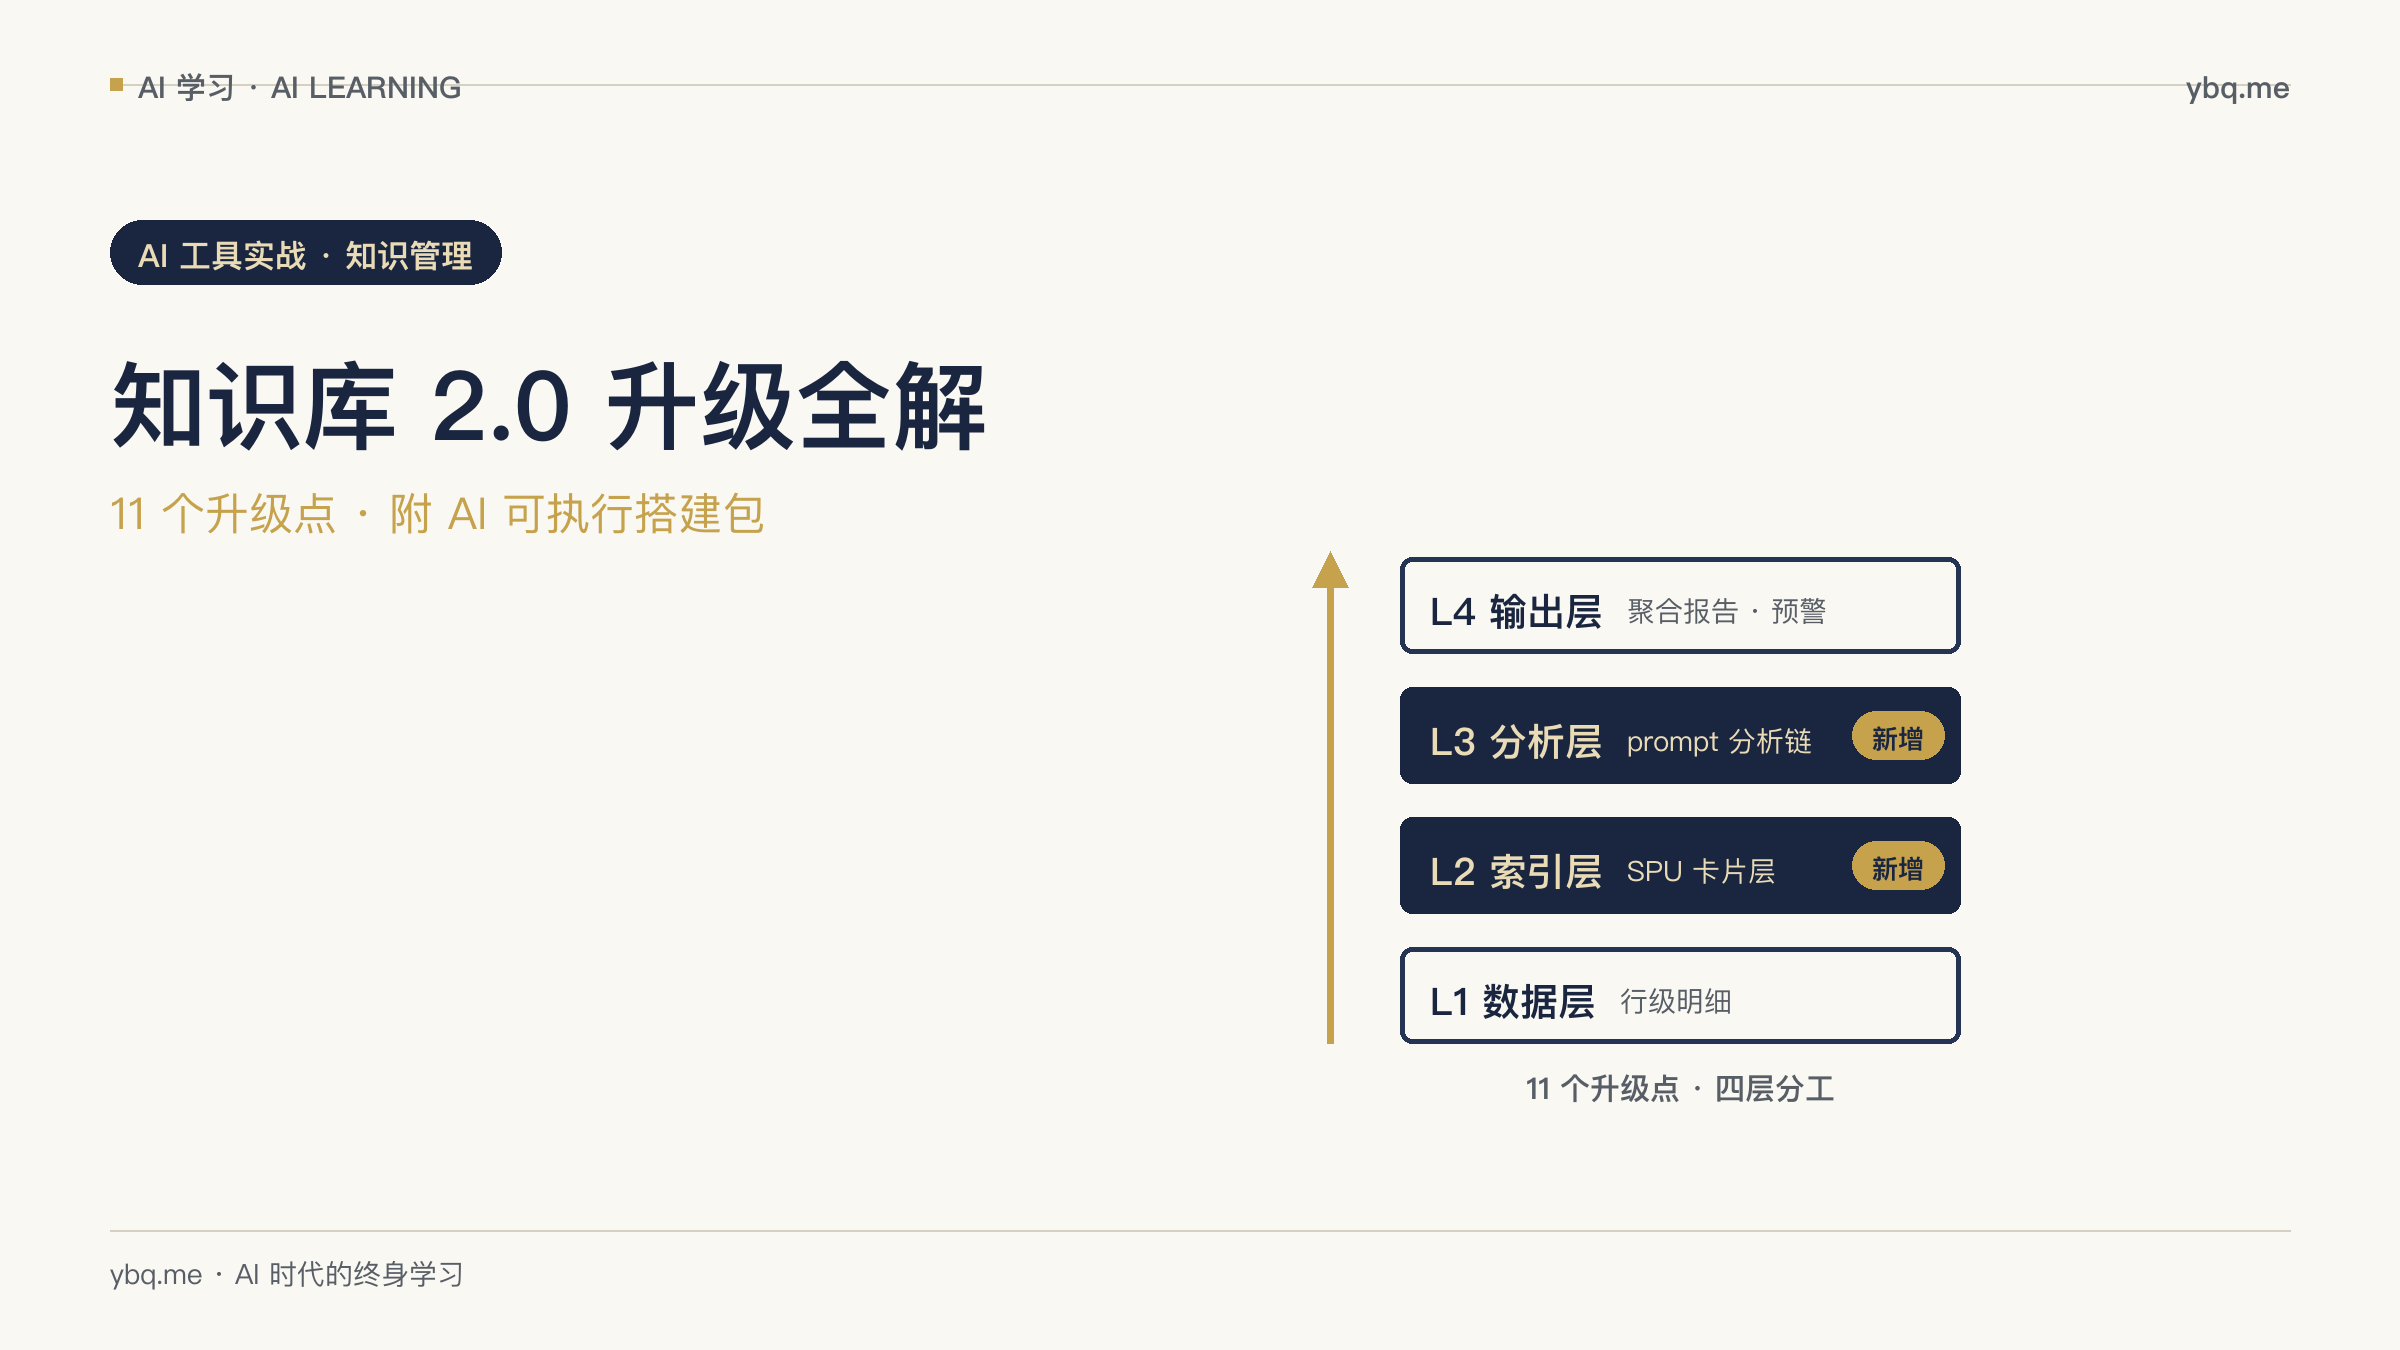
这是「本地 AI 知识库实践」系列的第五篇。前面四篇分别讲了怎么搭(v1 搭建)、怎么更聪明(v2 多跳检索)、怎么让数字可信(SPU 卡片索引)、以及 2.0 全部升级点的逻辑(2.0 全解),中间还插了一篇知识库质量审计。 这一篇是 Day 1 实录。我把知识库从「单管线 RAG」升级成了「三管线本体」,从凌晨两点半干到晚上十点,中间发现它一直在骗我。 一、凌晨两点半的怀疑 事情是这样的。凌晨两点半,我盯着屏幕,脑子里冒出一个特别不舒服的念头。 我这个天天在用的知识库,是不是在骗我。 我有个自己搭的知识库,里面是公司好几年攒下来的东西,采购记录、供应商档案、各种笔记,几万条明细,两百多家供应商。平时有什么想查的就问它一句,它检索一下给我个答案,还贴心地附上来源。 一直用得挺顺。 直到那天晚上聊事情,我心里突然咯噔了一下。它跨文件回答问题的时候,那些数字,真的是对的吗。它说「多个来源交叉验证一致」,那些来源,真的是独立的吗。 带着这个不舒服,我干了一件很 nerdy 的事。我出了一整套题去考它,43 道题,每道题我先自己去翻源文件,把标准答案和在第几行都抄下来,然后再去问它,一个字一个字地对。 结果把我看沉默了。 有一道特别典型的题,问某个采购品类四年一共花了多少钱。标准答案我去源文件里核对过,一个字一个字对的。它给我的答案,差了百分之七左右。 差得不算离谱对吧。离谱的是它的态度。它言之凿凿,说这个数字有六个独立来源交叉验证一致,可信度很高。 我顺着它给的来源一个个去翻。所谓六个独立来源,其实是三对文件,每一对都是同一个东西改名前后的两个副本,内容一字不差。它拿六份复印件互相印证,告诉我这是独立信源。 你敢信??? 这还不是最吓人的。更吓人的是我继续往下测,发现它有另外一批问题,干脆不回答。不是拒绝,是返回一片空白。我以为是随机故障,反复重试,同样的题,三次,全空。而正确答案明明就躺在它检索到的资料里。 还有一种更隐蔽的。有的问题,它会说「资料中查不到」。我一开始觉得这是诚实,挺好的。后来我翻文件发现,答案就在那里,它检索到了那个文件,只是没检索到带着答案的那一段,于是它基于残缺的上下文,斩钉截铁地告诉我这个东西不存在。 你看,这三种错误,一种编造,一种沉默,一种否认存在。最可怕的是第三种,因为它看起来最像诚实。 二、机制病 那天晚上我想明白了一件事。我的知识库得的是一种机制病,不是 bug。 它的工作方式是,把几万个文档切成碎片,按相似度捞出一把,然后让一个大模型把这些碎片拼成一个答案。这个机制天生擅长聊天,天生不擅长算术。你问它隔壁老王姓什么,它可能给你编一个。你让它把三百行数据加起来,它可能给你加错。这不是它笨,是它的构造里本来就没有「精确」这两个字。 所以修 bug 是没用的。机制病,要换机制。 顺带说个扎心的。我这个库上个月的「质量评分」是 9.6 分,看着挺美。这次实测之后我给它重新打了分,9.4。分数降了,但这次是卸了妆的 9.4——把「检索会稳定输出作废数字」「八分之一的题直接空答」这些病全部显性化之后的分数。带病的 9.6 和卸妆的 9.4,我选后者。 三、三管线 我花了一整天,把知识库改成了三个各司其职的部分。 第一种问题,多少钱、占多少比例、哪年涨没涨。这类有唯一正确答案的,不让大模型碰。全部交给一个老会计,一个确定性引擎,数据从冻结的权威源一次性灌进去,带指纹校验,查询全程没有生成模型的参与。你问账上的事,他翻账本,一分钱不会错,账上没有的,他会说这条查不到。 第二种问题,这家供应商还供着哪些品类、这个物料断供了有没有替代、交易链条里有没有绕圈的关联。这类要顺着关系一层层往下爬,老会计的账本翻不动。我给它画了一张地图,把几万条采购明细变成一张图,供应商、物料、品类、年份全是节点,采购行为全是边。查询就是在地图上走路,走一步是一步,走到没有路,就承认没有路。 第三种问题,才是真正需要大模型的。某个东西为什么重要,某篇文章讲了什么道理。这类没有唯一答案,让大模型发挥。但我也给它上了规矩,旁边配了个门卫,检索到的资料里如果混着过期的、被作废的来源,门卫直接把问题拦下来,把权威文件的路径列出来让我自己去查。 我给这套东西立了一条规矩,叫宁拒不错。答不了就拒答,拒绝不算失败,编造才算。这条规矩立完之后我发现,系统回答我的方式都变了。以前它是个什么都敢说的百科全书,现在它更像那个靠谱的老会计。 说真的,这句话值钱。 四、把几万条明细画成一张图 图本体是这天的重头戏。采购明细83,715 行,每一行变成一条带属性的边,供应商、物料、品类、年份变成节点,再加供应商映射、品类归并、关联方关系,六类实体一张图,60 多 MB 的 SQLite 单文件,零新服务,指纹不符直接拒答。 老规矩,建完先建锚点再考它。采购总额、分年金额、供应商数量、品类数量,全部对上才算建成功。然后再注入一个故意改错的总额,看它认不认。它拒绝了。很好,坏锚点混不进去。 然后是十道多跳压测题。每道题都要跨五个以上的资料来源,在关系链上爬好几层,全是旧系统必挂的题型。 五、十道题,零编造 压测结果,十道题里零编造。 我印象最深的是一道跨了好几层的题。我问它,那几个供应大头,除了自己的主业,还偷偷往哪些品类渗透。它挨个在图上爬完,回来告诉我,一家只干主业,一家在九个品类里各有零星几千块的边角料,头部仍然只有主业。还有一家,直接查无此人。 查无此人这四个字,后来我发现也是准的。因为那家的叫法和图库里的登记名,真的对不上。它没有硬凑一个名字相似的家伙来交差。 还有一道跨域题,问销售线和采购风险有没有重叠。它在采购半段直接给了个硬结论,某关联方 entity 就挂在该品类供应商头部,和另一道题测出的「该关联方在某品类占九成」互相咬合。而销售域那半段,它老实承认图里没有这个概念,拒答。 ...