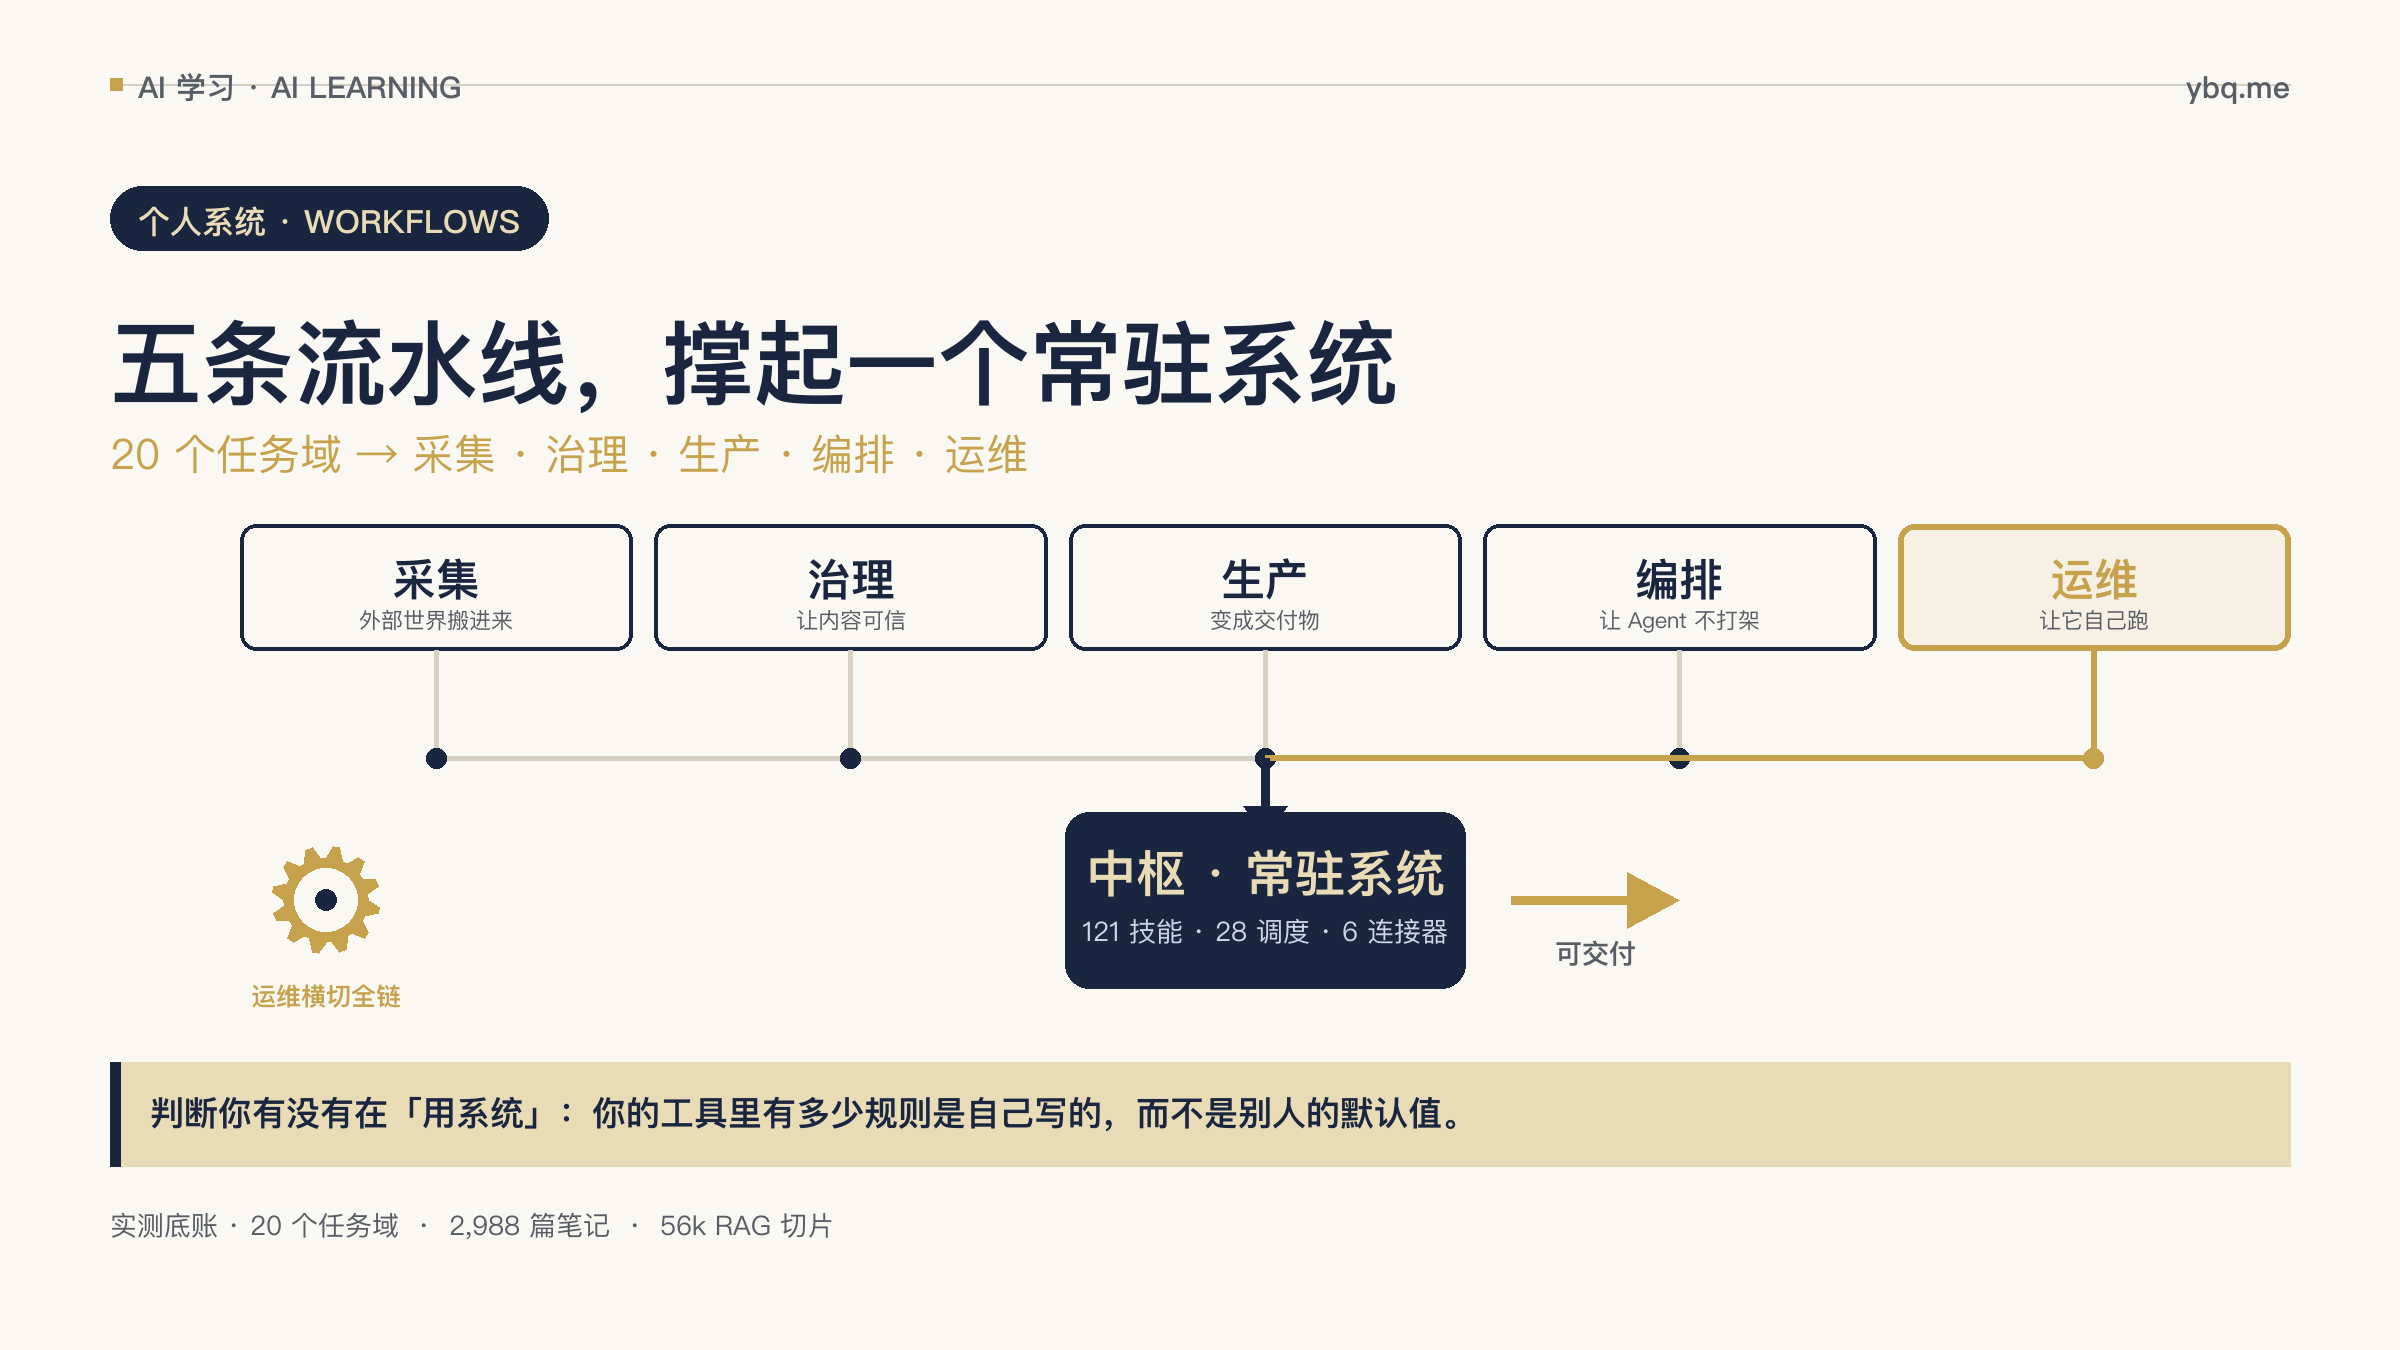
五条流水线汇入 WorkBuddy 中枢

我怎样把 WorkBuddy 用成一套常驻系统:20 个任务域背后的五条流水线

大多数人对 AI 工具的使用,停在「问答」这一层:想到什么问什么,问完就关。这个用法的问题不是效率低,而是它把 AI 降级成了一个更快的搜索引擎——你每次都在重新建立上下文,而 AI 每次都从零开始。 我用了 WorkBuddy 足够久,久到它不再是一个工具,而是我数字工作的一部分。这篇文章不复述我做了多少事,而是回答一个更有用的问题:这些事是怎么被组织起来的? 下面的底账全部来自本次实测,不是凭印象回忆: 维度 实测值 用户级技能 121 个 定时自动化 28 个(26 个在跑 / 2 个暂停) 已绑定外部连接器 6 个 知识库规模 约 2,988 个 md 文件 · 56k 个 RAG 切片 这四个数字背后,是五条常年同时运行的流水线。 一、你不是在使用工具,你是在运营一个系统 先说一个被普遍低估的事实:AI 工具的产出质量,取决于你为它设计的结构,而不是你提问的水平。 同样一个人用同一个 AI 工具,有人的用法是「一个文件夹、一堆 md、一句 prompt」;有人的用法是—— 121 个技能,每个技能是一个被验证过的流程,不是一段提示词 28 个定时任务,按黄金时段排布,凌晨干活、白天只看结果 4 层记忆:身份档案、用户偏好、项目日志、每日复盘 一套验收机制:任何「完成」声明前必须实测磁盘 这两种用法的产出差距,不是 10 倍,是两个量级。原因很简单:前者每次都在重新发明轮子,后者把轮子的制造过程本身沉淀成了资产。 我把这 121 个技能理解为流程的固化层——每一次踩坑之后问自己一句「这个坑值得写下来吗」,如果值得,它就变成一个技能,下次不用再踩。 所以判断你有没有在「用系统」,有一个简单的测试:你的 AI 工具里,有多少东西是你自己写的规则,而不是别人的默认值。 二、五条流水线:把 20 个任务域归并后的骨架 我原本列了 20 个任务域(知识库治理、邮件抽取、AIMR 治理、GPO 季度跟踪……)。但 20 个是并列关系,看不出结构。真正的结构是五条流水线——每个域都是某条流水线上的一个工位。 ...
2026-10-07 · Gary
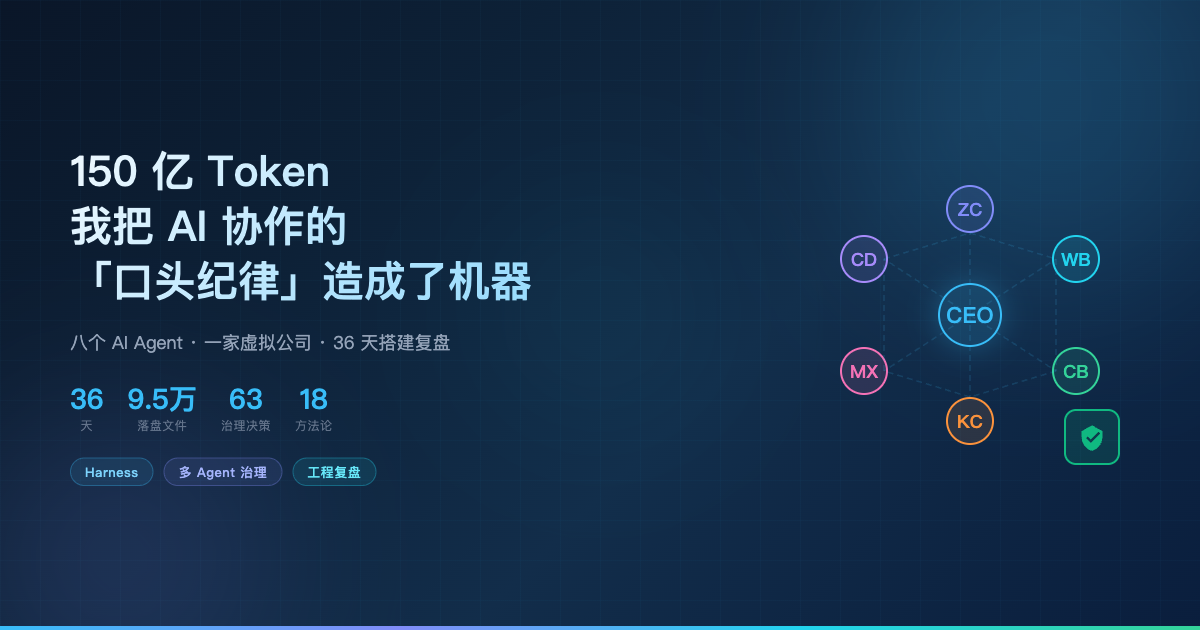
150 亿 Token:AI 协作 Harness 搭建复盘

150 亿 Token,我把 AI 协作的「口头纪律」造成了机器

一个多智能体 Harness 系统的完整搭建复盘 36 天 · 9.5 万份落盘文件 · 63 份治理决策 · 约 150 亿 Token 先给一组实测数字,这篇文章的每一节都会回到它们: 维度 数字 口径 Token 消耗 约 150 亿 运营者估算口径¹,跨全部 Agent 会话累计,含大量重放与测试;系统自身无法精确计量 治理时间窗 36 天(2026-08-11 → 09-15) 决策记录首末日期实测 工作区落盘文件 95,686 个 交付当日 find 实测 Harness 机制文档 716 个 00_HARNESS/ 目录实测,其中带日期戳的 229 份集中在 5 天内产出 治理决策 20 份公司决策 + 42 份董事长指令 07_决策记录/ 与 01_董事长指令/ 实测 常驻钩子 6 个,2,169 行代码 ~/.zcode/hooks/ 实测,全部带运行留痕 ¹ 「150 亿」是运营者跨全部 Agent 会话的累计估算,含大量重放、回归测试与行为基线消耗。系统至今无法跨供应商精确归集 Token——这本身就是本文第十章指出的体系盲区之一。实际生产性消耗约为总量的三到四成。 ...

2026-09-16 · Gary
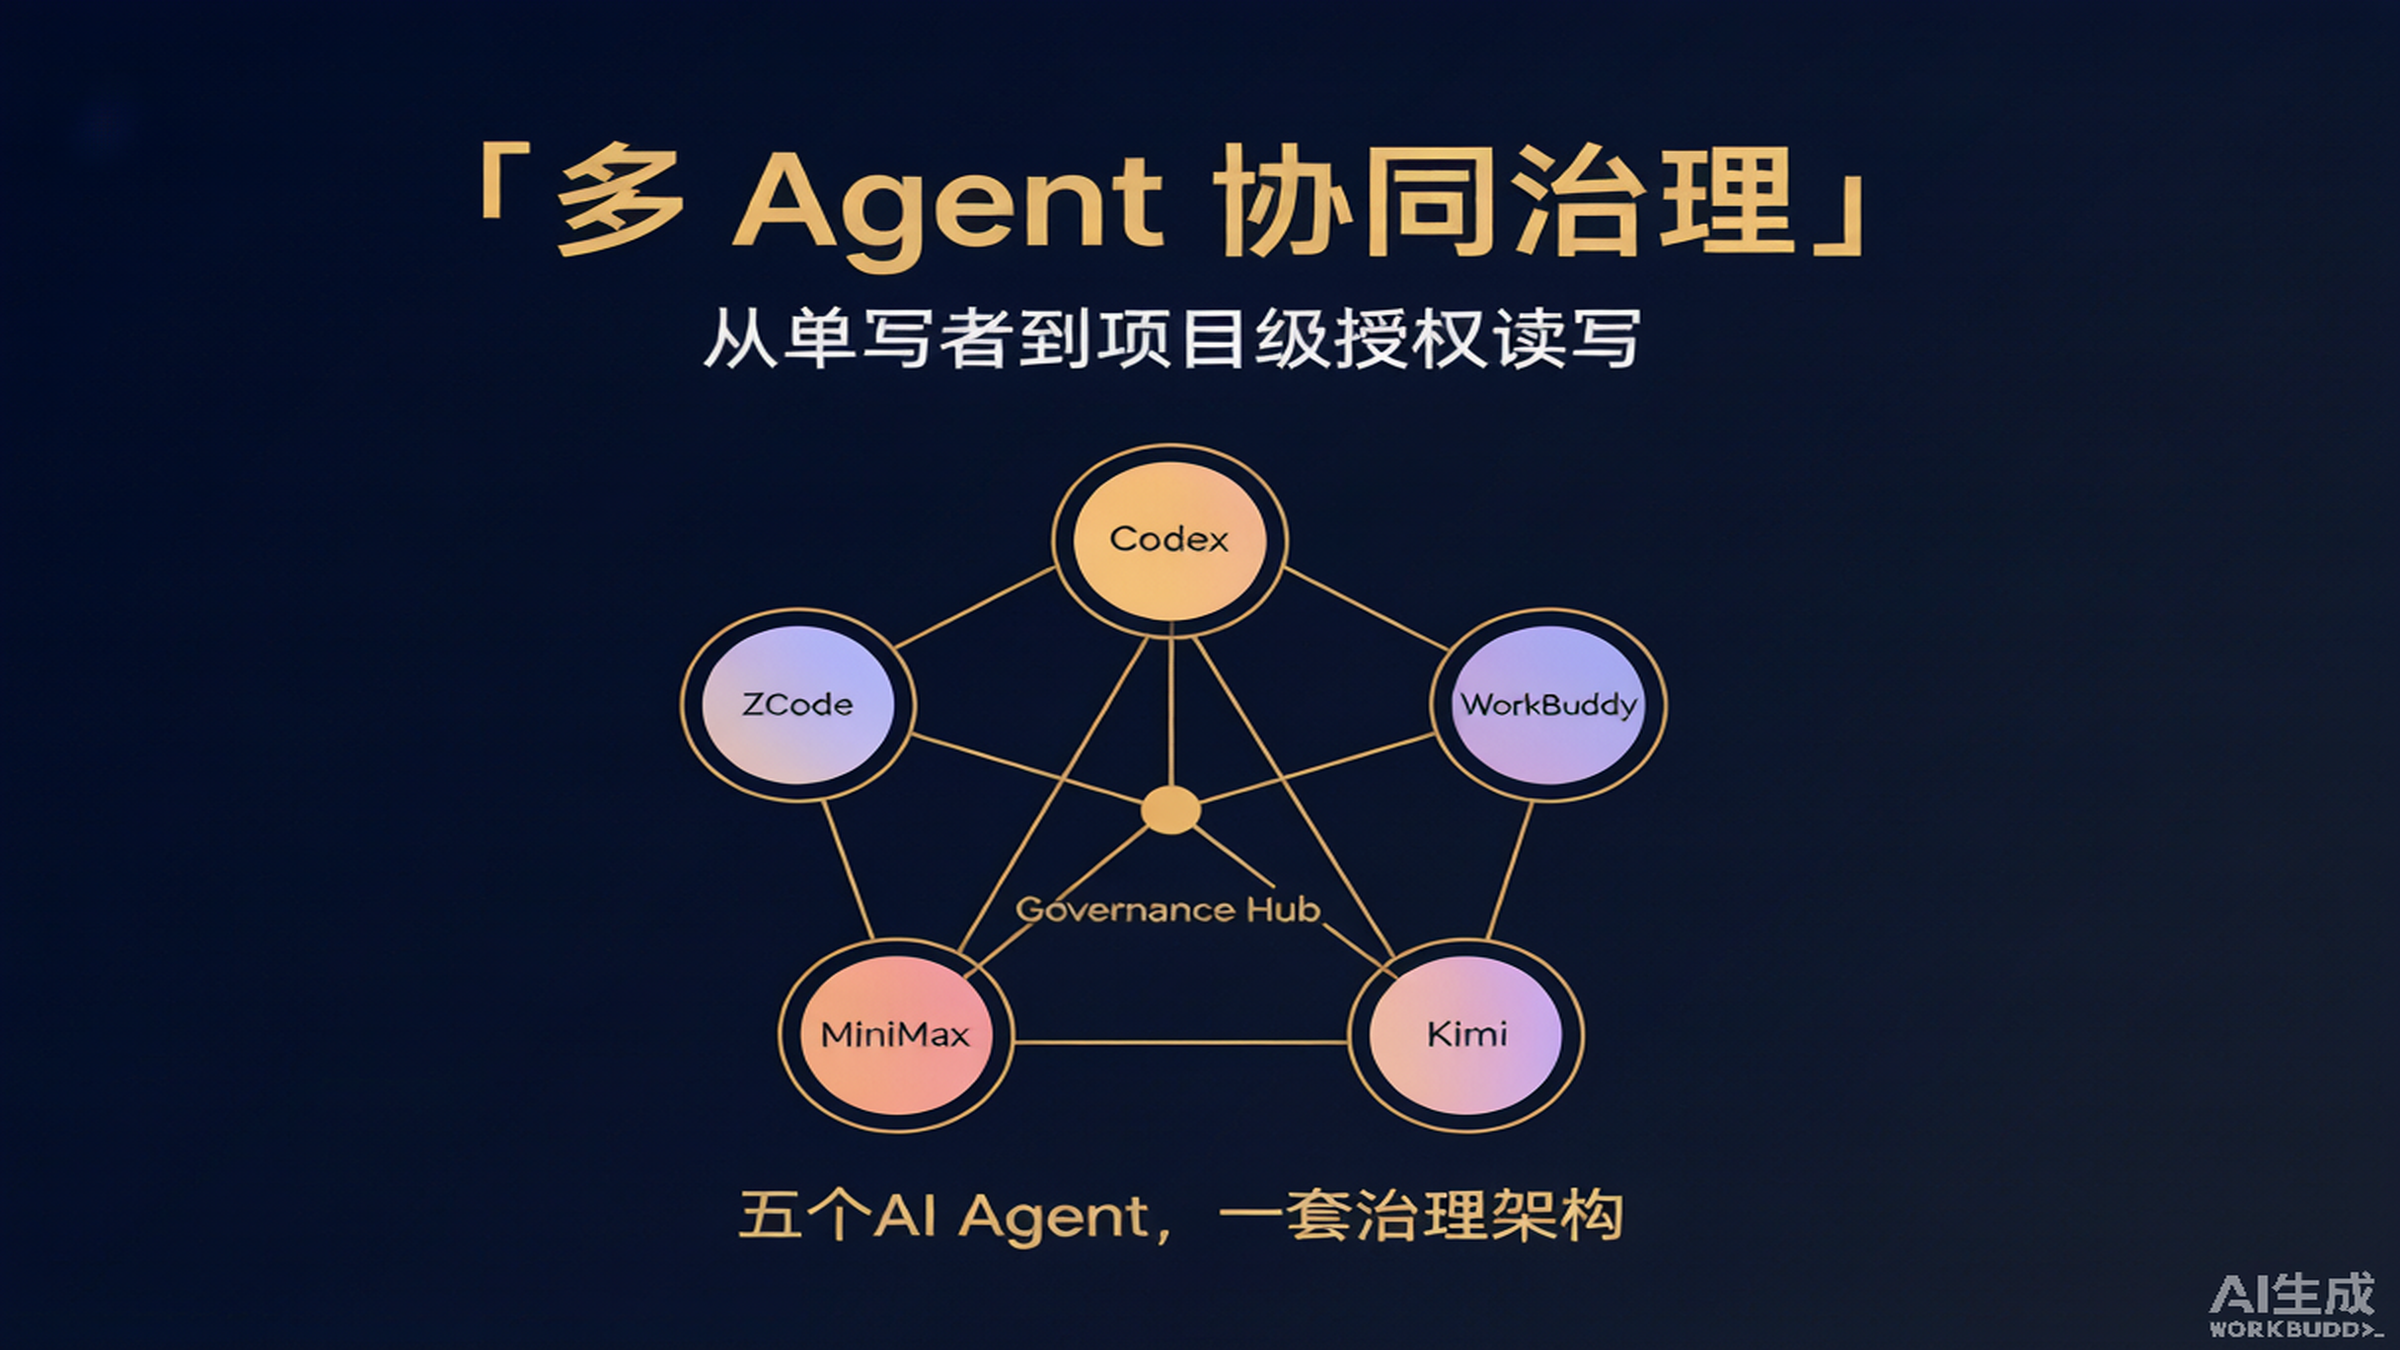
多 Agent 协同治理架构

多 Agent 协同治理:从单写者到项目级授权读写

版本说明(2026-08-31):本文描述的"双索引 RAG"是 2026-07 的架构快照。2026-08 起知识库已简化为单索引 + SPU 卡片索引层——表格聚合的职责由「防爆块规则 + 排除清单」和「SPU 卡片层」承接(详见《从零搭建本地 AI 知识库》)。治理原则、权限矩阵与交接闭环不受影响,仍然完全有效。 你有没有遇到过这种场景:你让 AI 帮你改一个文件,改完发现另一个 AI 也在改同一个文件,两边改的内容互相覆盖,最后谁的都没保留? 这不是技术 bug,是治理缺失。 我有一个 5000+ 文件的知识库,用双索引 RAG(A 索引含表格聚合 / B 索引零表格,numpy 向量 + reranker)做检索。当我开始引入多个 AI Agent(Codex、WorkBuddy、ZCode、Kimi Work、MiniMax Code)协同工作时,新问题出现了:谁来写?谁来审?怎么协调?RAG 什么时候更新? 我要说一个大多数人不同意的观点:AI Agent 的能力不是瓶颈,治理才是。 大多数人以为"Agent 不够聪明"是问题——错了。真正的问题是"Agent 太自由了"——它们能写任何文件、改任何配置、跑任何命令,但没有人告诉它们"什么不该做"。这就像给 5 个实习生每人一把公司钥匙,但没有门禁系统——迟早出事。 本文拆解我从踩坑到成熟的三轮迭代:从"一个 Agent 垄断所有写入"到"项目级授权读写",最终找到一套稳定的多 Agent 治理架构。 一、问题:建完 RAG 之后的新困境 上篇写完时,我的知识库已经跑起来了:5000+ 文件、双索引 RAG(A 索引含表格聚合 / B 索引零表格)、每日增量同步、领域 wiki。技术层没问题。 但当我开始引入多个 AI Agent 协同工作时,新问题出现了: 谁来写? 如果 5 个 Agent 都能改同一个文件,冲突只是时间问题。 谁来审? Agent 写的东西不一定对,需要有人把关。 怎么协调? A Agent 改了配置,B Agent 不知道,继续按旧配置执行。 RAG 什么时候更新? 文件改了但索引没更新,检索结果就是旧的。 这不是技术问题,是治理问题。技术问题有标准答案,治理问题没有——它需要你根据实际情况不断迭代。 ...

2026-07-28 · Gary