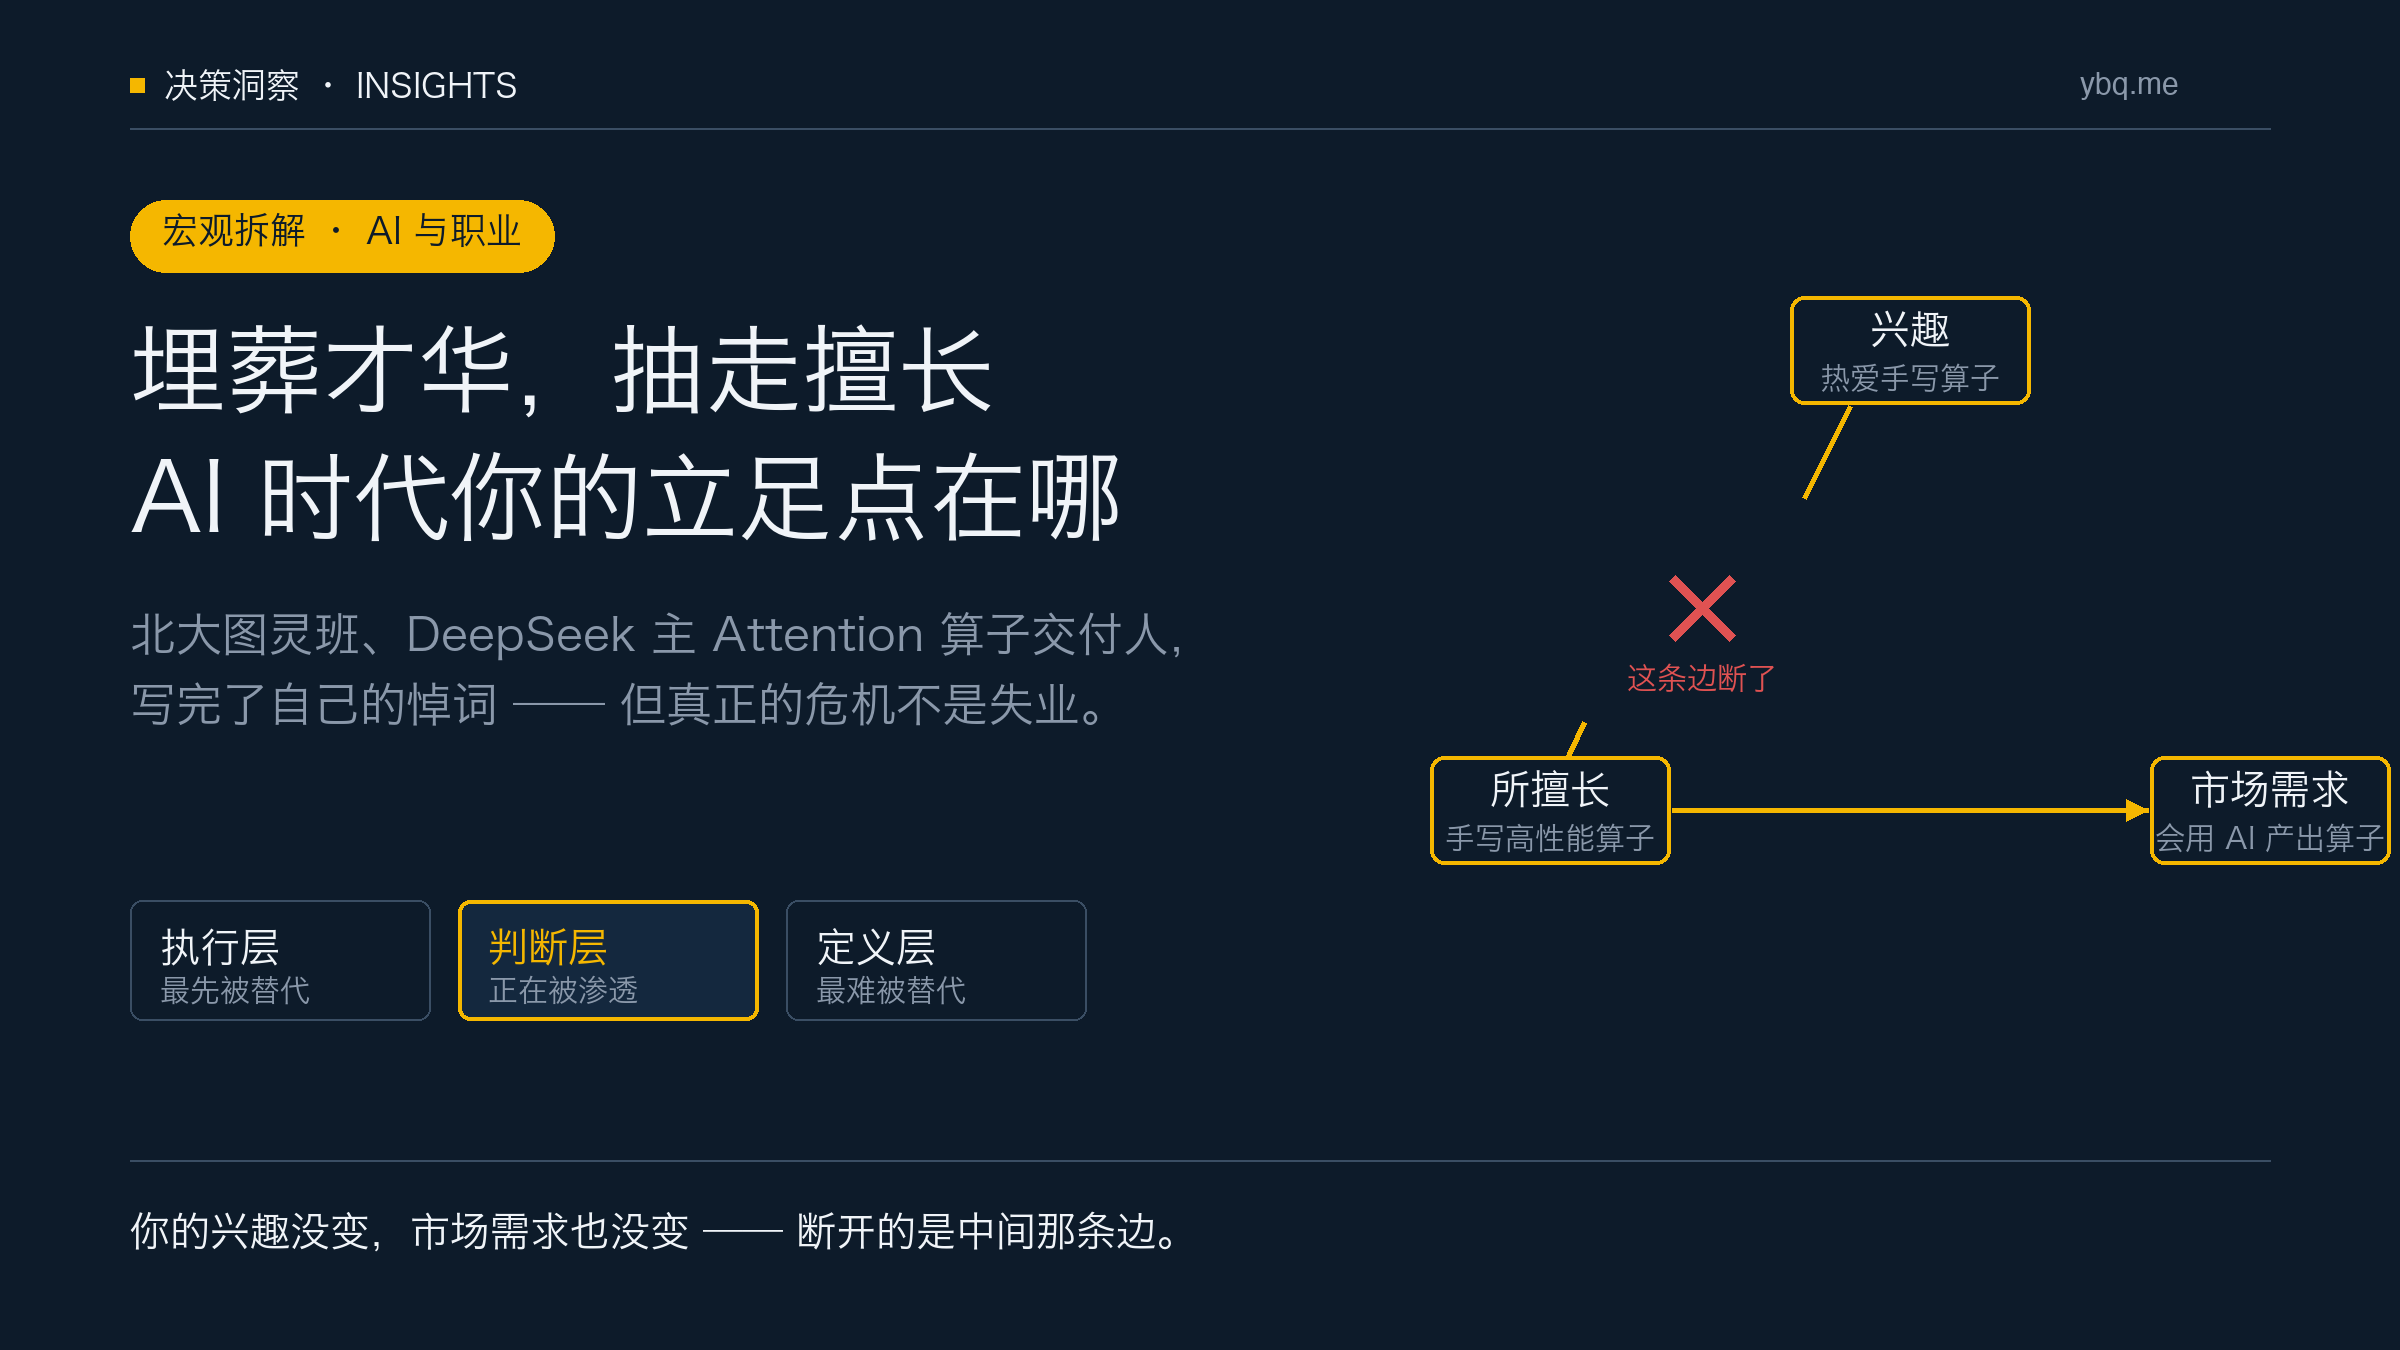
刘胜与的处境大概是所有技术人里最刺眼的一种:北大图灵班、未名超算队队长、ASC 全球冠军、DeepSeek v4.1 主 Attention 算子的交付人——刚刚交付了行业最核心的组件,然后坐下来写自己的悼词。
如果这篇只是在讲「AI 会不会取代我」,它不值得十万阅读。真正的分量在于:他描述的三个机制,作用范围远远超过算器工程师这一个职业,而且这三个机制彼此咬合,构成一个完整的解释框架。
那份口播讲稿的贡献在于,它把框架翻译成了普通人的语言,并补上了原文没说透的一层——「开源救不了普惠」。这个补充比原文本身更接近问题的实质。
下面把两者的洞察合起来,逐层推到底。
一、这不是一篇失业文
技术的悖论,比「越努力越快被取代」更深
原文那句是:
「我算子写得越好,我们的新模型的训练、推理速度就会越快,模型能力进步就会更快,我就会更早地被取代。」
讲稿把它归纳为「个体理性导致集体非理性」——对的,但没讲透。这个悖论的诡异之处不在于矛盾,而在于因果链的自我指向。
设一个人的努力为 e,全行业努力总量为 E,模型能力增长速度是 E 的正函数。AI 自主编写算子达到「优秀人类工程师水平」的时间点,记作 τ。那么对他个人而言:
| |
这是一条负向的自我强化链。 你的努力同时做了两件事:提高你自己的市场价值,以及降低你自己市场价值持续的时间。前者的收益是瞬时的——这一版的性能数字;后者的代价是永久的——你的能力被复制的时间点前移。
明知道还要做,因为有两层原因
原文给了两层,逻辑完全不同。
第一层是驱动力:「写算子对我来说就像打游戏一样……心中的激动程度不亚于游戏的速通玩家打破了自己过往的记录。」
这一层是结构性无解的。如果一个人从工作中获得的满足感是内生的,那么理性的「少做一点以延长职业寿命」根本无法被执行。喜欢一件事的人不会因为「这件事即将消失」而停止做它。
第二层是博弈:「哪怕我就此’摆烂’甚至故意下绊子耽误模型训练,其它家的模型也会照常发展并最终将我照杀不误。」
这是囚徒困境:个体理性(优化以保岗位)导致集体非理性(所有人共同加速一个自己不想要的未来)。喊 AI 该踩刹车永远没结果,因为一家踩刹车等于把位置让给对手,只有所有人一起踩才有意义。
但这里有一个被普遍忽略的转折
原文紧接着说:「我不至于会’失业’,但必须要’转业’。」
这句话把前面整段论证的目的翻转了。 如果只是担心被取代,结论应该是「怎么办」;但他给的是一个关于身份的判断——不是「我会不会失去位置」,而是「我必须放弃我热爱的那部分工作」。
技术悖论不是主题,「热爱的东西不再由人完成」才是。
二、三角错位——全篇最精确,也最被忽略的一句
「在之前,我的兴趣、我所擅长的、以及工业界所需要的,三者是基本对齐的;而现在,AI 让我所擅长的变成了它更擅长的,也让工业界的需求从『会写高性能算子的人』漂移到了『能用 AI 更快地产出高性能算子的人』。」
这一句的解释力,超过前面所有的金句。 讲稿完全没有引用它。
为什么工业时代这三者会对齐
不是因为巧合,是因为整个社会系统都建立在这三者对齐的前提上:
| 机制 | 作用 |
|---|---|
| 教育体系 | 告诉你「学什么有前途」,而这个答案来自「社会缺什么」 |
| 职业路径 | 资历 ≈ 能力 ≈ 报酬,熬年限就等于涨能力 |
| 市场定价 | 稀缺的技能获得溢价,供给减少则价格上升 |
闭环是:兴趣 → 愿意长期投入 → 形成稀缺能力 → 获得市场回报。一旦「所擅长的」同时也是「市场需要的」且「你恰好喜欢」,三者就形成自洽循环。
所谓职业规划,本质上是在维护这个三角的对齐。
AI 精确地抽走了哪一角
不是抽走「工作」,是抽走「所擅长的」这一角。后果非常具体:你的兴趣还在,市场需求也还在,但连接两者的那条路断了。
| |
市场端整体平移了:从「会写高性能算子的人」→「能用 AI 更快地产出高性能算子的人」。你的能力坐标没变,但坐标系变了。
为什么这比「被取代」更难受
被取代是一个状态,三角错位是一个过程。
被取代有明确的终点和仪式:通知、交接、下一份工作。三角错位没有——你还在做同样的事,但做的意义已经变了。产出不再稀缺,于是它不再构成你的身份支撑。
更微妙的是:你能力越强,这个错位感越强。
顶尖工程师恰恰是让错位来得最快的那批人,因为他的能力被复制得最彻底。这里有一个残酷的排序:
越是把某件事做到行业顶级的人,越快成为被自动化得最干净的对象。
这不是新的。软件开发史上已经演过一遍:汇编 → 编译器生成 → 高级语言 → 代码生成 → AI 补全。每一轮,最 proficient 的那一层都是最先被穿透的。 因为「专业」的定义是「对这个领域的细节掌握程度」,而自动化的目标恰恰就是「细节」。
织毛衣比喻的三个层次
原文用了织毛衣的比喻,是三层的:
第一层:质量过硬花纹美观,十里八乡的富人都来请你。手艺曾有真实的市场价值。
第二层:同行可以凭着机器轻松达到你曾经的水平,因此你不得不也去用它。这是同侪压力导致的转业,不是能力不行——标准换了。
第三层:凭借过去二十年攒下的技术,哪怕大家都有机器,你织毛衣的速度与质量也还能超过同行。存量能力仍有残值,这对应「不至于失业」。
三层合起来说的是:转业不是被剥夺,是被重新定价。 存量能力还在,但它从「稀缺性来源」变成了「锦上添花」。
而真正被拿走的是第三样东西:过程本身的乐趣。
「那份临窗听雨、引针穿线、慢度光阴的意趣,终究还是被机器的轰鸣碾碎了。」
桑内特提供了理论的名字
理查德·桑内特在《匠人》里说,手艺不只是技能,是一种认知方式:
「Craftsmanship names an enduring, basic human impulse, the desire to do a job well for its own sake.」 「……mental anticipation is privileged above concrete encounter; standards of quality in work separate design from execution.」
他反复论证的命题是:技能化的劳动本身就是一种思考,手会反过来教头脑。
这个理论放在 AI 语境下,结论变得锋利:
如果做(doing)本身是认知的来源,那么把「做」自动化掉,损失的不是劳动时间,是认知能力的输入渠道。
桑内特的两条机制是分开的:兴趣是驱动力,具身实践是认知来源。AI 拿走的是实践,而实践恰恰是认知的原料。所以损失是不可补的。
「丢掉的东西」和「必须继续活下去」之间的缺口
如果驱动力和实践通道同时没了,会发生什么?
会失去意义感,但不会失去产出能力。原文自己就体现了这一点:「我相信我能凭借着对工程学、上层模型需求和底层硬件的理解,继续高质量、高效率地产出算子。」
所以真正的痛点是:
你还能把事情做好,但不再为「是你在做」而自豪。
刘胜与在原文里给了一个近乎残酷的自白:
「我是一个理性和感性分离得比较开的人……记得我在搬离住了一年的出租屋时,还大哭了一场,舍不得和过去的记忆分别。今天和之前那个手写算子、人脑优化的时代告别,无疑比这更加残酷。」
这句话比「我不得不把才华埋葬在昨天」更诚实,也更重。前者是文学修辞,后者是私人记忆。 让人难以承受的从来不是抽象的「才华被埋葬」,而是具体的那一天、那个房间、那台显示器。
三、算力作为生产资料——讲稿最重要的一次推进
讲稿在讲 AI 对普通人的意义时,加了一节**「开源救不了普惠」**。这一节原文里没有(原文只说「最前沿的智能应该开放廉价地供应给所有人」,没说怎么做到),而讲稿给出了一个原文没给的结构性论证。
论证骨架:
- 模型权重开源 = 拿到模型参数(能力载体)
- 但权重不是「智能」本身——智能 = 权重 × 算力 × 数据
- 普通人就算能下到权重,一台机器跑不动
- 就算调用 API,「用得起」和「用得起多少」是两回事
一个可复用的判断结构
这是个约束层级问题。它不只发生在 AI 上。任何一次「技术可及性」的大幅提升,最终都会被下一个稀缺要素重新收口:
| 技术普及 | 打破了 | 但卡在 |
|---|---|---|
| 纸质书 | 知识的复制成本 | 识字率 |
| 公开课 | 受教育的经济门槛 | 学习动机 / 认证 |
| 云计算 | 算力的获得 | 供应商集中度 |
| 开源模型 | 模型权重 | 物理算力 |
核心洞见:开源是一个关于「可获得性」的陈述,不是关于「可及性」的陈述。可获得 ≠ 可及。 门槛被移除一层,下一层会浮现。
「开源」有两层含义被混淆了
- 权重开源 = 你可以获得模型
- 能力平权 = 你可以用与最强实验室同等的能力工作
前者永远比后者容易实现。 因为前者是分发问题,后者是资源问题。
所以判断一个「AI 普惠」叙事是否成立,问三个问题:
- 它降低的是分发成本还是算力成本?
- 如果是分发,下一层瓶颈是什么?
- 这个瓶颈由谁持有?
一个比「500GB 跑不动」更硬的论据
讲稿提到「V4.1 Flash 模型文件 500GB,个人跑不动」——方向是对的。而原文的脚注里有一个更硬的论据:
「主 Attention」仅包括 head dim=512 的 MQA attention,不包括用于选出 top-k 重要 token 的 indexer,那部分是由其他同事(以及他们的 AI Agent)编写的。
这是最前沿的实验室,在开源旗舰模型时,已经有一部分核心代码是 AI Agent 协作生产的。
这比「500GB 跑不动」更有说服力,因为它是一手事实而不是推断。它说明的不是「普通人拿不到模型」,而是**「模型本身的生产方式正在被改变」**——而这个改变速度,可能比「谁拥有算力」这个问题更快。
讲稿那句最值得拎出来的话
「开源解决的是权重的可得性,解决不了算力的可得性。」
这把一个技术问题上提成了一个结构问题。它是一个可以迁移的判断框架:
当你看到任何一个「开放 / 开源 / 普惠」的方案时,问一句:
它降低了哪一层的门槛?下一层的门槛由谁持有?
四、从「被取代」到「失去独特性」——框架的升级
讲稿在开头给出一个关键的重新定义:
「他讲的是,过去决定一个人能走很远的那几样本事,正在一样一样被 AI 改写。」
这比「AI 会不会取代我」高了一个层级。过去支撑一个人在市场上不可替代的,通常是三层,不是一层:
| 层次 | 内容 | 抗替代性 |
|---|---|---|
| 执行层 | 能把事情做出来 | 最先被替代(工具有效性) |
| 判断层 | 知道什么是对的、什么值得做 | 较难替代(需要上下文) |
| 定义层 | 知道什么值得被做 | 最难替代(涉及目的) |
AI 当前的能力主要在执行层,且正在向判断层渗透。定义层暂时没有触及,但原因不是技术做不到,而是目前还没有足够的商业动机去做。
这个分层解释了为什么「被取代」的焦虑会呈现出「一阵一阵」的形态——不是均匀推进,而是某一层被攻破时,焦虑集中爆发。
「没人看得出来」这句话的真正机制
「往后,工程能力差的人会越来越多……等到 AI 出错的那天,房间里没有一个人看得出来。」
完整逻辑链是:
- AI 让人「不需要练习」就能产出
- 因此下一代的执行层能力普遍下降
- 而判断力是执行层实践中长出来的
- 执行层实践被抽走 ⇒ 判断层的输入断了
- 多年后,这一代人有产出,但没有判断力
这才是真正的机制——不是「AI 太强」,而是**「人类这一代悄悄失去了发现错误的能力」**。
这和「AI 取代人类」是完全不同的风险类型。一个是现在,一个是十年后,而且后者更难逆转。
为什么「只有验收」必然导致判断力衰减
判断力的本质是一条反馈回路:
| |
判断力的强弱,取决于这条回路的「闭环次数」,也就是你在过去一年里多少次经历「我判断错了 → 我发现了我错在哪」。
AI 接手「做」之后:
- 你的「判断」不直接转化为结果
- 你失去了「我的判断被现实验证」这个环节
- 错误样本的获取,从「工作」转移到了「审阅 AI 输出」
- 而审阅错误的发现率,远低于自己做错时的发现率——因为 AI 的错误它自己都认为是对的
所以关键不是「要不要用 AI」,而是「你的判断力是否还有闭环次数」。 这两件事可以同时成立:大量使用 AI,同时保持足够的「独立产出 + 错误暴露」。
一个可以立刻执行的判据
问自己:上个月,我因为「自己判断错了」而修正了判断,几次?
如果这个数字接近零——无论你在用多先进的模型,判断力都在静默萎缩。不是因为你变懒了,是因为你的工作流里已经没有「会被现实反驳的时刻」了。
这个机制和我在 AI 错的那天,谁来看出来 里说的其实是同一件事:防守力的前提是你自己得有判断力。
五、智力商品化——分水岭到底在哪里
讲稿给出了这一层最清晰的表述:
「过去几百年,普通家庭的孩子想跨越阶层,最可靠的杠杆就是智力……但 AI 正在把智力从一种天赋变成一种可以购买的商品。说白了,从’你是谁’变成’你买得起什么’。」
这一层和前面几层的关系值得说清楚——它不是并列的第五点,而是前四层的结果:
| |
原文在这一层其实没有下结论
原文只是提了一个问题,没有回答:
「在未来社会中,权力是不是会比技术或智商更加重要?」
这个问题在原文中被抛出来了,但整篇文章没有再回到它。 这可能是他有意留下的:他在结构上看见了「权力化」的转向,但在个体上(「我相信凭着我的判断力,我能留在牌桌上」)又不愿意承认自己会从这次转向中掉出去。
讲稿补上了另一半:把「权力化」明确解释为「对算力和资源的支配」。
一个需要诚实的分岔
如果「智力可购买」这个命题成立,那么:
- 对多数个体:智力贬值是坏消息
- 对有判断力的人:判断力升值是好消息
- 对结构:整体上智力被重新定价,稀缺性转移
这三者同时成立。 「智力贬值」和「判断力升值」不矛盾——它们是同一枚硬币的两面,因为前者是后者的前提。只有当执行层的智力被商品化,判断层的判断力才会凸出为新的稀缺。
真正的分水岭从哪来
讲稿说「算力的分配」,我补一个更精确的表述:
新的分水岭 = 算力的可获得性 × 判断力的可获得性
前者是经济问题,后者是认知问题。 前者不平等,后者不平等。 两者的叠加,才是阶层固化。
这比单说「算力垄断」更完整:算力决定你能调动多少智能,判断力决定你能否用好这些智能。两者缺一,天花板就锁死。 而这两者的获取路径完全不同——前者靠钱,后者靠「愿意在小事上被现实反驳」。
六、可以怎么做
三个判断
一、不要抢「做」的领先,要守住「判断」的输入
原文的转业(去当机甲驾驶员)是理性选择——把执行层让出去,专注在定义层和判断层。但讲稿补了一个关键约束:不能把判断层也一起让出去。 判断层的能力来自执行层的实践,如果执行层完全让渡,判断层会空转。
原文的处境其实是「我知道判断力还在,但我没机会继续用手艺来练它了」——这是一种能力衰减的隐忧。他自己没提,但三角错位的机制说明:判断力也是靠实践喂出来的。
二、判断力的「具体性」是护城河
抽象的「我知道该做什么」很容易被写成 prompt。难的是在这个具体情境里,知道该做什么——而这需要你在这个情境里待过足够久、犯过足够多的错。
AI 能生成方案,但很难生成「这个人的判断力」——因为判断力本身就是「在这个具体世界里的错误历史」的函数。
三、可及性是分层的,AI 也是
让普通人接入 AI 不等于让普通人用上最好的 AI。「能用」和「用得起」是两件事。理解这个分层,就知道自己在链条的哪一层。
一个可以立刻用的自查表
对应第四层的「反馈闭环」机制:
| 检查项 | 怎么问 | 健康信号 |
|---|---|---|
| 闭环次数 | 上个月我因为「自己错了」而修正判断,几次? | ≥ 1 次/月 |
| 不可替代层 | 我现在在做的活儿,属于执行 / 判断 / 定义哪一层? | 至少部分在判断或定义层 |
| 三角对齐 | 我的兴趣 / 最擅长 / 市场需要,三者还对得上吗? | 至少两者对齐 |
| 原始输入 | 我还亲手「做」东西吗? | 每周有 1–2 次完整的手工产出 |
| 可及层级 | 我用的 AI,在整条链上处于第几层? | 知道自己不处于哪一层 |
「别把手全撒开」的操作原则
讲稿的收束句是:
「用最强的工具去当机甲驾驶员,但是别把手全撒开。」
这句是对的,但可以补一个具体的操作原则:
「别把手全撒开」= 定期刻意做一批「会失败的任务」。
不是为了产出,是为了重新获得「我判断错了 → 我发现了」的机会。 AI 能帮你完成 90%,但那 90% 里没有你的错误样本——你的判断力需要那 10%。
这也是我一直在做的事。这篇文章本身就是一次尝试:把一个热点话题拆到机制层,拆到能被反驳的位置。如果你在某个地方不同意,那正是这套方法生效的证据——你刚刚完成了一次闭环。
尾注:材料来源与口径
- 一手原文:刘胜与《我不得不把才华埋葬在昨天》(2026-09-14 微信公众号首发,约 3000 字)
- 口播讲稿:9 分 26 秒,对原文的解读
口径声明:
- 文中「原文」指刘胜与本人表述;「讲稿」指口播解读者表述;「本文」指基于两者的分析推论。
- 涉及原文具体表述与引文的部分,均可回溯至原文全文。
- 讲稿中有若干二手数字与型号表述不准确。本文的论证不依赖任何未经验证的数字——凡涉及推断处均已标明为推论。
本文为深度解读稿,基于公开原文与口播讲稿的合流分析。